

文章目录
- 前置知识
- 基本概念
- 主从复制的问题
- 人工恢复主节点故障
- 哨兵自动恢复主节点故障
- 重新选举
- 选举原理
- 挑选从节点成为新主节点
- 总结
前置知识
Redis 的主从复制模式下,⼀旦主节点由于故障不能提供服务,从节点虽然能够提高读操作,但是从节点不能自动升级为主节点,不能替换原有主节点对于的角色
如果需要⼈⼯进⾏主从切换,同时⼤量的客⼾端需要被通知切换到新的主节点上,对于上了⼀定规模的应⽤来说,这种⽅案是⽆法接受的
基本概念
| 名词 | 逻辑结构 | 物理结构 |
|---|---|---|
| 主节点 | redis主服务 | 一个独立的redis-server进程 |
| 从节点 | redis从服务 | 一个独立的redis-server进程 |
| redis数据节点 | 主从节点 | 主节点和从节点的进程 |
| 哨兵节点 | 监控redis数据节点的节点 | 一个独立的redis-sentinel进程 |
| 哨兵节点集合 | 若干个哨兵节点的抽象组合 | 若干redis-sentinel进程 |
| redis哨兵 | redis提高的高可用方案 | 哨兵节点和redis主从节点 |
| 应用方 | 泛指多个客户端 | 一个或者多个连接redis的进程 |
主从复制的问题
Redis 的主从复制模式可以将主节点的数据改变同步给从节点,这样从节点就可以起到两个作⽤:
- 第⼀,作为主节点的⼀个备份,⼀旦主节点出了故障不可达的情况,从节点可以作为后备 “顶” 上来,并且保证数据尽量不丢失(主从复制表现为最终⼀致性)
- 第⼆,从节点可以分担主节点上的读压⼒,让主节点只承担写请求的处理,将所有的读请求负载均衡到各个从节点上
但是主从复制模式并不是万能的,它同样遗留下以下⼏个问题:
- 主节点发⽣故障时,进⾏主备切换的过程是复杂的,需要完全的⼈⼯参与,导致故障恢复时间⽆法 保障
- 主节点可以将读压⼒分散出去,但写压⼒/存储压⼒是⽆法被分担的,还是受到单机的限制
第⼀个问题是⾼可⽤问题,即 Redis 哨兵主要解决的问题。第⼆个问题是属于存储分布式的问 题,留给 Redis 集群去解决
从节点和主节点之间断开连接,有两种情况:
1.从节点通过命令slaveof no one主动和主节点断开连接
- 此时从节点能够晋升成为主节点 (意味着程序员要主动修改redis的组成结构)
2.主节点挂了
- 这个时候从节点不会晋升为主节点,需要通过人工干预的方式恢复主节点
人工恢复主节点故障
Redis 主从复制模式下,主节点故障后需要进⾏的⼈⼯ 作是⽐较繁琐的
Redis 主节点故障后需要进⾏的操作
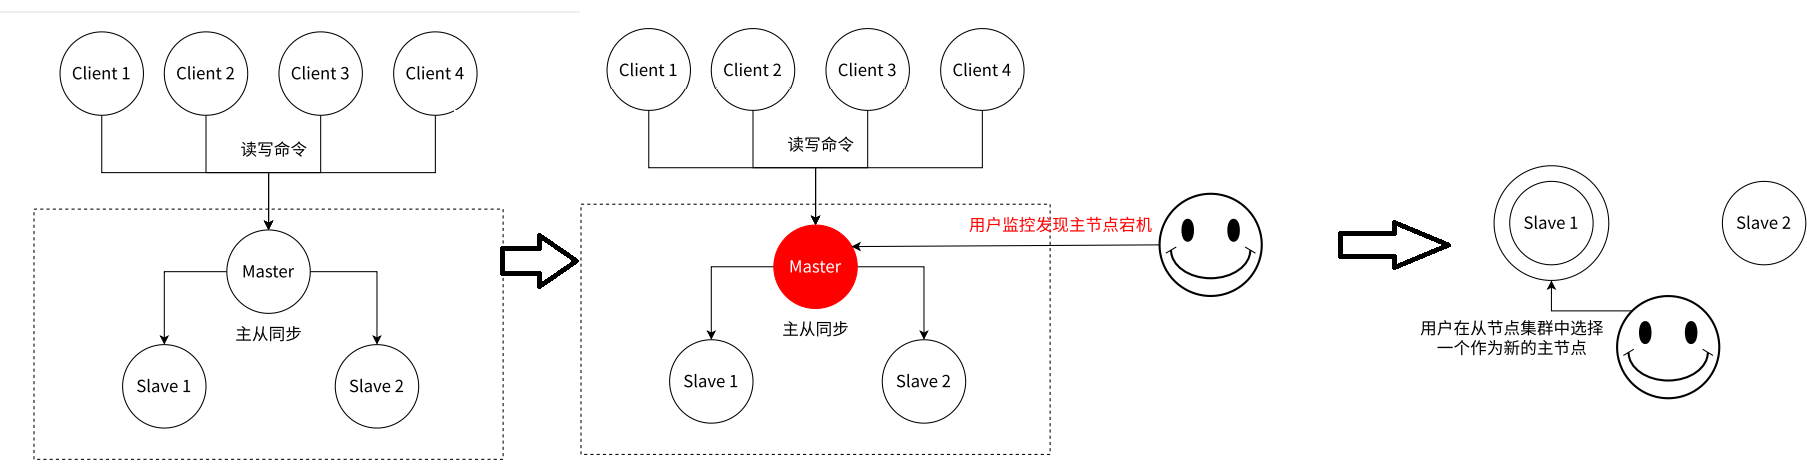
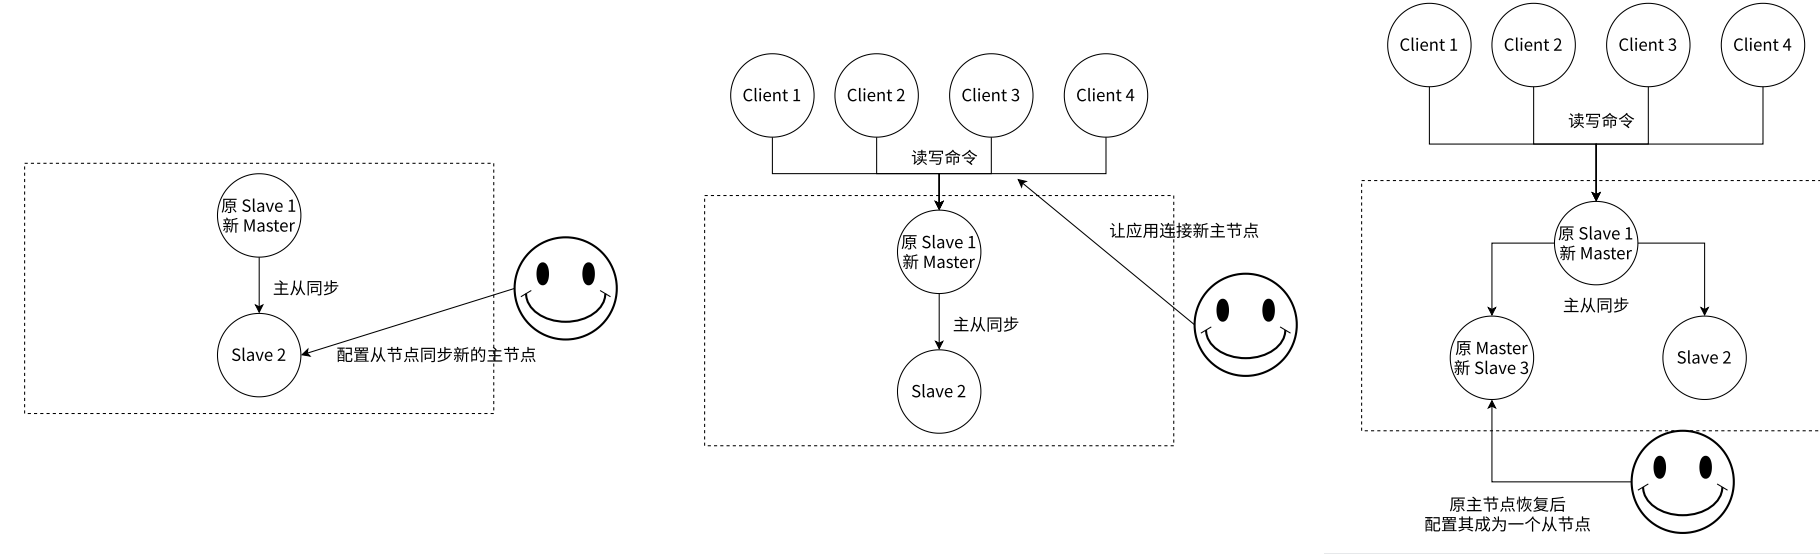
1)运维⼈员通过监控系统,发现 Redis 主节点故障宕机,先看看主节点这边是否能抢救一下/好不好抢救,如果主节点这边不好定位是什么原因挂掉的/短时间难以解决,那么就需要设置新的主节点
2)运维⼈员从所有从节点中,选择⼀个(此处选择了 slave 1)执⾏ slaveof no one,使其作为新的主 节点
3)运维⼈员让剩余从节点(此处为 slave 2)执⾏ slaveof {newMasterIp} {newMasterPort} 从新主节点开始数据同步
4)更新应⽤⽅连接的主节点信息到 {newMasterIp} {newMasterPort}(修改客户端的配置)
5)如果原来的主节点恢复,执⾏slaveof {newMasterIp} {newMasterPort}让其成为⼀个从节点
哨兵自动恢复主节点故障
哨兵机制是通过独立的进程来体现的,和之前的redis-server是不同的进程,redis-sentinel不负责存储数据,只是对其它的redis-server进程起到监控的效果,通常哨兵节点也会搞一个集合(由多个哨兵节点组成),主要是为了防止单个哨兵节点挂了
当主节点出现故障时,Redis Sentinel 能⾃动完成故障发现和故障转移,并通知应⽤⽅,从⽽实现真正的⾼可⽤。Redis Sentinel 是⼀个分布式架构,其中包含若⼲个 Sentinel 节点和 Redis 数据节点,每个 Sentinel 节点会对数据节点和其余 Sentinel 节点进⾏监控,当它发现节点不可达时,会对节点做下线 表⽰
- 如果下线的是主节点,它还会和其他的
Sentinel节点进⾏ “协商”,当⼤多数Sentinel节点对 主节点不可达这个结论达成共识之后,它们会在内部 “选举” 出⼀个领导节点来完成⾃动故障转移的 ⼯作,同时将这个变化实时通知给 Redis 应⽤⽅ - 整个过程是完全⾃动的,不需要⼈⼯介入
Redis Sentinel 架构
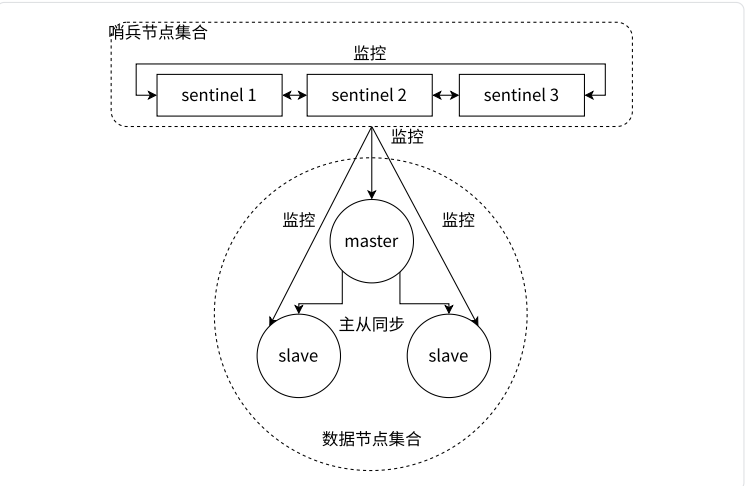
Redis Sentinel 相⽐于主从复制模式是多了若⼲(建议奇数个)Sentinel 节点⽤于实现监控数据节点,哨兵节点会定期监控所有节点(包含数据节点和其他哨兵节点)
- 监控:进程之间建立TCP长连接,通过长连接定期发送心跳包监测对方的存活状态
如果从节点挂了,其实没有多大关系,如果是主节点挂了,哨兵就要发挥作用了,此时一个哨兵节点发现一个主节点挂了还不够,还需要多个哨兵节点来共同认同这件事情,主要是为了防止出现误判
针对主节点故障的情况,故障转移流程⼤致如下
- 1)主节点故障,从节点同步连接中断,主从复制停⽌
- 2)哨兵节点通过定期监控发现主节点出现故障。哨兵节点与其他哨兵节点进⾏协商,达成多数认同主节点故障的共识
- 这步主要是防⽌该情况:出故障的不是主节点,⽽是发现故障的哨兵节点,该情况经常发⽣于哨兵节点的⽹络被孤⽴的场景下
- 3)哨兵节点之间使⽤
Raft算法选举出⼀个领导⻆⾊,由该节点负责后续的故障转移⼯作 - 4)哨兵领导者开始执⾏故障转移:从节点中选择⼀个作为新主节点,控制被选中的从节点执行
slaveof no one;让其他从节点修改slaveof到新主节点;通知应⽤层新主节点是谁,并且后续客户端再进行操作,就会针对新的主节点进行操作

通过上⾯的介绍,可以看出 Redis Sentinel 具有以下⼏个功能
- 监控: Sentinel 节点会定期检测 Redis 数据节点、其余哨兵节点是否可达
- 主节点故障转移: 实现从节点晋升(promotion)为主节点并维护后续正确的主从关系
- 通知: Sentinel 节点会将故障转移的结果通知给应⽤⽅
- 配置提供者: 在
Redis Sentinel结构中,客⼾端连接的是哨兵节点,从中获取主节点信息,⽽不是直接连接主节点
注意:哨兵节点只有一个也是可以的,但是如果只有一个,它本身也是容易出现问题的
- 万一这个哨兵节点挂了,后续redis节点也挂了,就无法进行自动的恢复过程了
- 出现误判主节点挂掉的概率也比较高,因为网络传输数据的过程当中容易出现抖动或者延迟或者丢包等情况
原则:在分布式系统当中,避免使用单点! 对应的是使用冗余
重新选举
当哨兵发现了主节点 sdown, 进⼀步的由于主节点宕机得票达到法定得票, 于是 master 被判定为 Odown
- 主观下线(
SDown): 当前哨兵感知到主节点没⼼跳了. 判定主节点下线了 - 客观下线(
ODown):多个哨兵达成⼀致意⻅(法定票数), 才能认为主节点确实下线了
Redis 主节点如果宕机, 哨兵会把其中的⼀个从节点, 提拔成主节点,当之前的 Redis 主节点重启之后, 这个主节点被加⼊到哨兵的监控中,并且会附属到新选举的主节点上
选举原理
假定当前如上图所述: 三个哨兵(sentenal1, sentenal2, sentenal3), ⼀个主节点(redis-master), 两 个从节点(redis-slave1, redis-slave2),当主节点出现故障, 就会触发重新⼀系列过程
- 主观下线
哨兵节点通过心跳包判定redis服务器是否正常工作,当主节点宕机, 此时主节点和三个哨兵之间的心跳包就没有了。此时, 站在三个哨兵的⻆度来看, 主节点出现严重故障. 因此三个哨兵均会把主节点判定为主观下线 (SDown)
- 客观下线
此时, 哨兵 sentenal1, sentenal2, sentenal3 均会对主节点故障这件事情进⾏投票. 当故障得票数 >= 配置的法定票数之后,此时意味着主节点发生故障这个事情被做实了,此时触发客观下线 (ODown)
sentinel monitor redis-master 172.22.0.4 6379 2 //这个配置当中的2就是代表法定票数
- 选举出哨兵的 leader
接下来需要哨兵把剩余的 slave 中挑选出⼀个新的 master. 这个⼯作不需要所有的哨兵都参与. 只需要 选出个代表 (称为 leader), 由 leader 负责进⾏ slave 升级到 master 的提拔过程 => 选举的过程涉及Raft算法
假定⼀共三个哨兵节点, S1, S2, S3:
1… 每个哨兵节点都给其他所有哨兵节点, 发起⼀个 “拉票请求”. (S1 -> S2, S1 -> S3, S2 -> S1, S2 -> S3, S3 -> S1, S3 -> S2)
2 . 收到拉票请求的节点, 会回复⼀个 “投票响应”. 响应的结果有两种可能, 投 or 不投
- ⽐如 S1 给 S2 发了个投票请求, S2 就会给 S1 返回投票响应,到底 S2 是否要投 S1 呢? 取决于 S2 是否给别⼈投过票了. (每个哨兵只有⼀票),如果 S2 没有给别⼈投过票, 换⽽⾔之, S1 是第⼀个向 S2 拉票的, 那么 S2 就会投 S1. 否则则不投
3.⼀轮投票完成之后, 发现得票超过半数的节点, ⾃动成为 leader
- 如果出现平票的情况 (S1 投 S2, S2 投 S3, S3 投 S1, 每⼈⼀票), 就重新再投⼀次即可
- 这也是为啥建议哨兵节点设置成奇数个的原因. 如果是偶数个, 则增⼤了平票的概率, 带来不必要的开 销.
4.leader 节点负责挑选⼀个 slave 成为新的 master. 当其他的 sentenal 发现新的 master 出现了, 就 说明选举结束了
Raft 算法的核⼼就是 “先下⼿为强”. 谁率先发出了拉票请求, 谁就有更⼤的概率成为 leader,具体选出的哪个节点是 leader, 这个不重要, 重要的是能选出⼀个节点即可
- 这⾥的决定因素成了 “⽹络延时”. ⽹络延时本⾝就带有⼀定随机性
问:是否可能出现非常严重的网络波动导致所有的哨兵都连续不上redis主节点,导致误判主节点挂了呢
有的!但是如果出现这个情况,怕是用户的客户端也连不上redis主节点了,此时这个主节点基本也没办法正常工作,挂了不一定是进程崩溃,只要是无法正常访问都可以认为是挂了
挑选从节点成为新主节点
挑选规则
1.⽐较优先级. 优先级⾼(数值⼩的)的上位. 优先级是配置⽂件中的配置项( slave-priority 或者 replica-priority ).
2.⽐较replication offset谁复制的数据多, ⾼的上位
3.比较run id,谁的id更小,谁上位
当某个
slave节点被指定为master之后,
leader 指定该节点执⾏ slave no one , 成为 master,然后指定剩余的 slave 节点, 都依附于这个新 master
总结
上述的操作都是redis自动完成的,解决了主节点宕机之后需要⼈⼯⼲预的问题, 提⾼了系统的稳定性和可⽤性.
注意事项
- 哨兵节点不能只有⼀个. 否则哨兵节点挂了也会影响系统可⽤性.
- 哨兵节点最好是奇数个. ⽅便选举 leader, 得票更容易超过半数
- 哨兵节点不负责存储数据. 仍然是 redis 主从节点负责存储。所以哨兵节点可以使用一个配置不高的机器来进行部署(但是不建议一台机器上部署多个哨兵节点)
- 哨兵 + 主从复制解决的问题是 "提⾼可⽤性", 不能解决 “数据极端情况下写丢失” 的问题
- 哨兵 + 主从复制不能提⾼数据的存储容量. 当我们需要存的数据接近或者超过机器的物理内存, 这样的结构就难以胜任了,为了能存储更多的数据, 就引⼊了集群