

整理读研期间做的项目与日常小实验
本篇未完待续…代码部分整理后补充
0. 背景
实验室有一些材料的SEM(扫描电镜)图像、也有对应的组分信息(结构化数据,包含类别特征和连续的数值特征),以及对应的力学性能指标。
当时看多模态论文比较多,便想着既然有数据,正好可以用这些数据练习一下,于是,搭建一个多模态融合的模型,融合图像信息和材料的组分信息两种模态的数据信息,进行回归预测。
1. 网络结构
搭建的多模态融合模型框架如下图所示:
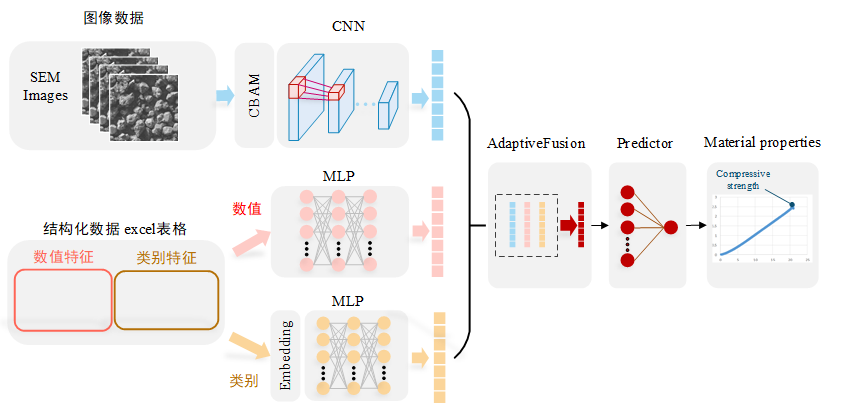
网络模型如下图所示:

2. 结构分析
2.1 CBAM模块
CBAM模块如下:


2.2 网络A结构

2.3 网络B结构

2.4 AdaptiveFusion结构
(1) 结构1


(2) 结构2
Concat or Sum
(3) 结构3
MHSA

3. 代码
3.1 数据集制作划分代码
import pandas as pd
import numpy as np# TODO 1. 数据集普通划分方式'''
- 数据集划分: 采用SEMDL软件进行划分。
- 相关代码见对应的数据管理软件模块。
'''def get_k_fold_data_split(k,X):# X 为 np.array# 返回第i折交叉验证时所需要的训练和测试数据,分开放,X_train为训练数据,X_test为验证数据assert k > 1fold_size = X.shape[0] // k  # 每份的个数:数据总条数/折数(向下取整)nums_train = int(fold_size*0.2)print("nums_train:",nums_train)X_train = NoneX_test = Nonetemp_data = Nonefor j in range(8):print('j:',j)idx = slice(j * fold_size, (j + 1) * fold_size)print(idx)temp_data = X[idx,:]temp_data = temp_data.copy()np.random.shuffle(temp_data)idx1 = slice(0, 192)  # slice(start,end,step)切片函数 得到测试集的索引print('idx1',idx1)X_part1 = temp_data[idx1, :]  # 只对第一维切片即可if X_train is None:X_train = X_part1else:X_train = np.vstack((X_train, X_part1))  # 其他剩余折进行拼接 也仅第一维print('xtrain:',X_train.shape)idx2 = slice(192, 240)  # slice(start,end,step)切片函数 得到测试集的索引print('idx2',idx2)X_part2 = temp_data[idx2, :]  # 只对第一维切片即可if j == 0:X_test = X_part2else:X_test = np.vstack((X_test, X_part2))  # 其他剩余折进行拼接 也仅第一维print('x_test:', X_test.shape)return X_train, X_testdef k_split_data_split():''':return:F:\paper_work\dataset_sem\dataset_yasuo\100x\exp39组较长验证数据集 L{i+1}_train.csv  L{i+1}_val.csv'''k = 14  # 设置折数# 读取数据文件# F:\paper_work\dataset_sem\dataset_yasuo\100x\exp3\data.csvfilename = r'F:\paper_work\img_dataset\performence\train_val_test.csv'  # 原始所有数据dir_name = r'F:\paper_work\img_dataset\performence'  # 保存路径# 以上为需要设置的参数df = pd.read_csv(filename, header=None, index_col=None)df = np.array(df)print(df.shape)# 数据集划分后报保存路径train,test = get_k_fold_data(k,df)train_name = dir_name + '\\' + f'train_val.csv'val_name = dir_name + '\\' + f'test.csv'pd.DataFrame(train).to_csv(train_name, header=None, index=None)pd.DataFrame(test).to_csv(val_name, header=None, index=None)# TODO 2. 数据集K折交叉验证划分方式pass
# 辅助函数 用于辅助 k_split_data函数
def get_k_fold_data(k, i, X):# X 为 np.array# 返回第i折交叉验证时所需要的训练和测试数据,分开放,X_train为训练数据,X_test为验证数据assert k > 1fold_size = X.shape[0] // k  # 每份的个数:数据总条数/折数(向下取整)X_train, y_train = None, Nonefor j in range(k):idx = slice(j * fold_size, (j + 1) * fold_size)  # slice(start,end,step)切片函数 得到测试集的索引X_part = X[idx, :]  # 只对第一维切片即可if j == i:  # 第i折作testX_test = X_partelif X_train is None:X_train = X_partelse:X_train = np.vstack((X_train, X_part))  # 其他剩余折进行拼接 也仅第一维return X_train, X_testdef k_split_data():''':return:F:\paper_work\dataset_sem\dataset_yasuo\100x\exp39组较长验证数据集 L{i+1}_train.csv  L{i+1}_val.csv'''k = 9 # 设置折数# 读取数据文件# F:\paper_work\dataset_sem\dataset_yasuo\100x\exp3\data.csvfilename = r'F:\paper_work\dataset_sem_p2\dataset_kfold\data.csv' # 原始所有数据dir_name = r'F:\paper_work\dataset_sem_p2\dataset_kfold' # 保存路径# 以上为需要设置的参数-----df = pd.read_csv(filename,header=None,index_col=None)df = np.array(df)print(df.shape)# 数据集划分后报保存路径# k折交叉验证 划分数据集for i in range(9):train_name = dir_name + '\\'+f'L{i+1}_train.csv'val_name = dir_name + '\\'+f'L{i+1}_val.csv'print('*****************************')train,test = get_k_fold_data(k, i, df)pd.DataFrame(train).to_csv(train_name,header=None,index=None)pd.DataFrame(test).to_csv(val_name, header=None, index=None)# 裁剪数据集 只保留原先的val 前三十个
def save30pre():for i in range(9):path_ori = r'F:\paper_work\dataset_sem_p2\dataset_kfold\backup'+'\\'+f'L{i+1}_val.csv'path_out = r'F:\paper_work\dataset_sem_p2\dataset_kfold' + '\\' + f'L{i+1}_val.csv'df = pd.read_csv(path_ori, header=None, index_col=None)df = df[:][:30]df.to_csv(path_out,index=None,header=None)print(df.shape)if __name__ == '__main__':k_split_data()
3.2 模型结构代码
3.3 模型训练代码
3.4 相关绘图代码
附录1、CNN卷积层特征图可视化
下图为SEM图像中间特征层的可视化效果:
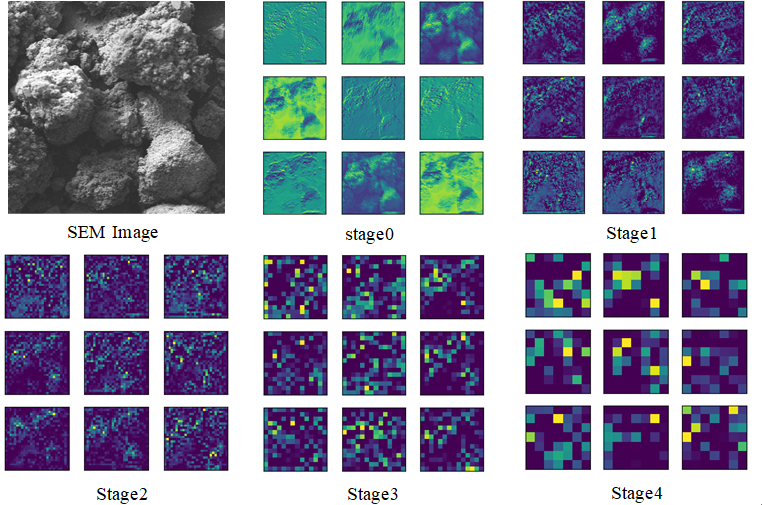
实现代码可以参考下面:
【卷积神经网络卷积层提取的特征图可视化】
pass