
)
Attacking Fake News Detectors via Manipulating News Social Engagement----《通过操纵新闻社交互动来攻击假新闻检测器》
摘要
在年轻一代中,获取新闻的主要来源之一是社交媒体。随着新闻在各种社交媒体平台上日益流行,虚假信息和毫无根据的言论的传播也随之激增。随着提出了各种基于文本和社交背景的虚假新闻检测器,最近的研究开始 关注虚假新闻检测器的漏洞。在本文中,我们提出了 第一个针对基于图神经网络(GNN)的假新闻检测器的对抗性攻击框架,以探讨其鲁棒性。具体而言,我们利用 多智能体强化学习(MARL)框架 来模拟社交媒体上欺诈者的对抗行为。研究表明,在现实世界的环境中,欺诈者相互协作,共享不同的新闻,以逃避虚假新闻检测器的检测。因此,我们将我们的多智能体强化学习(MARL)框架建模为一个具有机器人、半机器人和群众工作者智能体的 马尔可夫博弈。这些智能体各自具有独特的成本、预算和影响力。然后,我们使用深度 Q-Learning 来搜索最大化奖励的最优策略。对两个真实世界假新闻传播数据集的大量实验结果表明,我们提出的框架可以有效地破坏基于 GNN 的假新闻检测器的性能。我们希望本文能为未来假新闻检测的研究提供见解。
引言
随着社交媒体的蓬勃发展,不准确或毫无根据的信息(即虚假/错误信息)也在社交媒体上传播,这降低了人们对真理和科学的信念[6, 40]。与新闻机构通过媒体发布的传统新闻文章不同,评论和分享等社交活动会加速错误信息的传播并大规模夸大其影响力。最近的研究指出,在 COVID-19 全球大流行期间,错误信息一直阻碍疫苗的推广并威胁公众健康 [26]。
为了打击社交媒体上的大量错误信息,提出了许多基于机器学习的错误信息检测器[48]。除了利用自然语言处理技术来检查新闻内容及其写作风格以验证其真实性的方法[21,36,46]之外,最近的研究开始利用使用图模型对新闻社交参与进行事实检查[3, 27, 30, 35]。与简单的基于自然语言处理的方法相比,基于社交参与的方法将参与的用户视为新闻帖子的组成部分。基于理论和证据,新闻消费者对新闻内容有偏好(即“回音室”)[10, 16, 27, 29, 39],虚假信息和事实的参与模式也是不同的。此外,参与虚假新闻帖子的普遍存在的机器人和欺诈者也在参与模式上与常规参与者有所区别[37]。
尽管自动事实核查迅速发展,但大多数虚假新闻检测器是静态模型,容易受到对抗性攻击。与许多安全问题类似,我们必须承认,错误信息检测是内容审核者和恶意行为者之间的一场武装竞赛,其目标是通过激发社交参与来操纵公众舆论或获取金钱。因此,提高错误信息检测器的鲁棒性势在必行。尽管最近的一些工作研究了基于 NLP 的错误信息检测器的鲁棒性 [1,18,19,24,49],但没有任何工作探讨基于社交参与的错误信息检测器的鲁棒性。[24]和[28]是与我们最接近的两篇作品。然而,他们要么没有考虑基于社交参与的检测器,要么没有对错误信息活动中的不同欺诈者类型进行建模。
我们使用图 1 来演示基于社会参与的错误信息检测器的漏洞。许多现有的作品 [30, 35] 将社交媒体上的新闻社交参与建模为 异构图,其中用户和新闻帖子是节点,边意味着用户分享了该帖子。图神经网络(GNN)[15,22,45]已被广泛用于对上述社交参与图进行编码并预测新闻帖子的准确性。许多 GNN 被设计为对邻居节点信息进行编码,以增强目标节点的预测性能。利用这一特性,正如图1 所示,那些已经分享了许多真实新闻的欺诈者可以通过分享目标虚假新闻来扭转基于图神经网络的虚假信息检测器对其的预测。因为真实新闻邻居会减轻新添加的目标假新闻的可疑性。
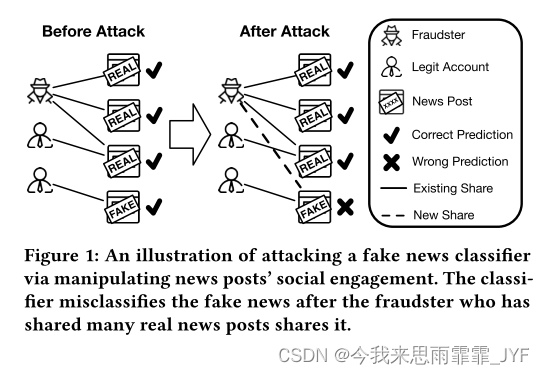
为了分析基于社交参与的错误信息检测器的鲁棒性,受 GNN 鲁棒性研究 [42] 的启发,我们建议通过模拟欺诈者的对抗行为来攻击基于 GNN 的错误信息检测器。然而,现实世界的错误信息活动给攻击模拟带来了三个重要的挑战:(1) 为了在社交媒体上宣传虚假新闻时逃避检测,恶意行为者只能操纵受控的用户帐户来分享不同的社交帖子。然而,之前的大多数 GNN 对抗攻击工作都假设所有节点和边都可以被扰动,这是不切实际的。(2) 许多部署的基于 GNN 的假新闻检测器都是 灰盒模型,具有针对异构用户帖子图定制的各种模型架构。因此,以前的作品[50]使用的基于梯度的优化方法不能用来设计攻击。(3) 现实世界的证据 [31, 44] 显示,各种协同的恶意行为者参与了错误信息活动。不同类型的恶意行为者具有不同的能力、预算和风险偏好。例如,关键意见领袖的影响力较大,但培养他们的成本更高。
为了克服上述挑战,我们设计了一个专用的多智能体强化学习(MARL)框架,而没有使用之前的 GNN 鲁棒性工作。具体来说,为了模拟分享不同帖子的欺诈者的真实行为,我们 利用深度强化学习框架,通过修改分享帖子的用户的连接来翻转目标新闻节点的分类结果。我们将 MARL 框架建模为马尔可夫博弈,其中代理协调工作以改变分类结果。总的来说,我们的 贡献 是:
- 据我们所知,我们是 第一个 从 社交参与角度 探讨 基于 GNN 的假新闻检测器的鲁棒性 的工作。尽管之前已经有使用 NLP 方法攻击假新闻检测器的工作,但通过操纵新闻目标的社交参与来攻击假新闻检测器尚未被研究。
- 我们利用 MARL 框架对基于 GNN 的假新闻检测器执行有针对性的攻击,以模拟现实世界的错误信息活动。具体来说,我们将欺诈者建模为在我们的框架中具有不同成本、预算和影响力的代理。
- 我们的实验结果表明,我们提出的 MARL 框架可以有效地改变 GNN 预测结果。我们讨论了基于 GNN 的假新闻检测器的漏洞,并提供了有关攻击策略和对策的见解。
相关工作
在本节中,我们回顾一下(1)基于图神经网络的假新闻检测的相关工作; (2)图神经网络的对抗性攻击; (3)假新闻检测的对抗性攻击。
基于 GNN 的假新闻检测
我们可以根据它们的图原型将现有基于图神经网络的虚假信息检测工作划分为两个主要类别:1)基于传播的工作[17,27,29,41]:这些工作将新闻帖子的共享序列建模为树形结构的传播图,其中新闻帖子作为根节点,边代表用户之间的共享关系。它可以表示为传播图分类或根节点分类任务。传播图对于对抗性攻击来说是不可行的,因为攻击者需要雇用大量用户来共享目标帖子来改变其分类结果。同时,此类操作对于优化来说很简单,并且可以通过简单的异常值测量轻松捕获。2)基于社会情境的工作[5,30,35,47]:所有用户及其共享的新闻帖子(例如推文)都会形成一个二分图(如图 1 所示),其中边表示用户共享该帖子,目标是训练 GNN 对新闻帖子节点进行分类。请注意,先前的研究通常将发布者作为连接到社交帖子的第三类节点。在本论文中,我们只考虑常用的图原型(即 用户-帖子二分图),因为在实践中更容易操作。
对 GNN 的对抗性攻击
由于 GNN 在许多图挖掘任务上取得了优异的性能,因此它们对抗对抗攻击的鲁棒性近年来引起了越来越多的关注[42]。RL-S2V [8]和Nettack [50]是两种早期的GNN攻击算法,旨在通过在给定预算下添加/删除边或修改节点特征来降低GNN的节点分类性能。在这些工作之后,其他工作也开始研究 GNN 在不同任务下的鲁棒性,例如链接预测 [4]、知识图嵌入 [34] 和社区检测 [25]。然而,之前的工作都没有尝试攻击基于 GNN 的假新闻检测器,这些检测器最近在大量对手参与虚假新闻传播的背景下变得流行起来[37]。与之前使用强化学习攻击 GNN 的工作相比,我们的工作利用 多代理设置 来模仿现实世界的错误信息活动。此外,为了模拟现实世界的攻击设置,我们只操纵新闻社交参与图的边,因为攻击者不太可能修改新闻帖子。
对虚假新闻检测器的对抗攻击
鉴于大量基于机器学习的假新闻检测器,只有少数研究研究了假新闻检测器的鲁棒性或漏洞[1,9,18,19,23,24,49]。在这些工作中,[19] 研究了基于文本的新闻真实性分类器随着时间的推移以及针对通过操纵新闻源发起的攻击的鲁棒性。[1,23,49]通过设计各种扭曲新闻内容或注入对抗性文本的攻击来探测基于 NLP 的假新闻检测器的鲁棒性。Nash-Detect [9] 和 AdRumor-RL [28] 使用强化学习框架分别研究基于图的垃圾邮件检测器和谣言检测器的鲁棒性。MALCOM[24]从另一个角度进行攻击,修改每条新闻的评论,利用多源数据欺骗假新闻检测器。PETGEN [18] 通过生成一系列文本来攻击基于序列的错误信息检测器,从而模拟社交媒体上恶意用户的行为。与之前的工作不同,我们是第一个 使用多代理强化学习框架来探索基于社交情境的假新闻检测器的鲁棒性。
问题表述
我们将攻击基于社交参与的假新闻检测器的问题表述为攻击 用户-帖子 共享图上的 GNN。在本节中,我们首先定义基于 GNN 的假新闻检测器,然后介绍我们的对抗性攻击目标。
基于 GNN 的假新闻检测器
用户-帖子 共享图被定义为一个二分图 G = { U , V , E , X u , X v , Y } G = \{ U,V,E,{X_u},{X_v},Y\} G={U,V,E,Xu,Xv,Y},其中 U = ( u 0 , . . . , u i ) U = ({u_0},...,{u_i}) U=(u0,...,ui) 是一组用户, V = ( v 0 , . . . , v j ) V = ({v_0},...,{v_j}) V=(v0,...,vj) 是一组新闻帖子,边 e i j = ( u i , v j ) ∈ E {e_{ij}} = ({u_i},{v_j}) \in E eij=(ui,vj)∈E 表示用户 u i {u_i} ui 分享了新闻帖子 v j {v_j} vj 。 X u {X_u} Xu 和 X v {X_v} Xv 分别是用户节点和新闻节点的两个特征矩阵。根据之前的工作[10,17,30],用户和新闻的特征向量可以由他们的文本表示或手工特征组成。按照[10],我们使用用户历史帖子和新闻帖子文本的 300 维 Glove 嵌入来分别表示 X u ( i , : ) {X_u}(i,:) Xu(i,:) 和 X v ( j , : ) {X_v}(j,:) Xv(j,:)。为了方便起见,我们使用 X X X 来表示所有节点特征。 y j ∈ Y {y_j} \in Y yj∈Y 表示 v j ∈ V {v_j} \in V vj∈V 的标签,其中 1 代表假新闻,0 代表真实新闻。
为了检测基于 G G G 的假新闻,可以应用通用的 GNN 框架 [15, 45]。具体来说,为了学习新闻文章 v v v 的表示,GNN 递归地聚合其邻居的信息:
h v ( l ) = σ ( h v ( l − 1 ) ⊕ A G G ( l ) ( h u ( l − 1 ) , ( u , v ) ∈ E ) ) h_v^{(l)} = \sigma (h_v^{(l - 1)} \oplus AG{G^{(l)}}(h_u^{(l - 1)},(u,v) \in E)) hv(l)=σ(hv(l−1)⊕AGG(l)(hu(l−1),(u,v)∈E))
其中, l l l 是 GNN 层数。 AGG 是聚合邻居嵌入的 GNN 聚合器。常见的聚合器采用注意力[45]、平均值[15]和求和[15]。 ⊕ \oplus ⊕ 表示将最后 GNN 层的 v v v 嵌入与其聚合的邻居嵌入相结合的操作。常见的方法包括串联和求和。类似地, u u u 的表示可以通过等式(1)所示的相同过程来学习。
为了对新闻帖子 v ∈ V v \in V v∈V 进行分类,GNN 分类器 f f f 将 G G G 作为输入,其中 X u {X_u} Xu 和 X v {X_v} Xv 是 u u u 和 v v v 的节点特征。将最后一层的 h v {h_v} hv 馈送到 MLP 和 softmax 层后,它将 v ∈ V v \in V v∈V 映射到 y ∈ ( 0 , 1 ) y \in (0,1) y∈(0,1)。GNN 分类器可以在部分标记的帖子节点上进行训练,并以半监督方式使用以下交叉熵损失:
L G N N ( G , f θ ) = ∑ v j ∈ V − log ( y j ⋅ σ ( ( f θ ( E , X ) j ) ) ) {L_{GNN}}(G,{f_\theta }) = \sum\limits_{{v_j} \in V} { - \log ({y_j} \cdot \sigma (({f_\theta }{{(E,X)}_j})))} LGNN(G,fθ)=vj∈V∑−log(yj⋅σ((fθ(E,X)j)))
基于 GNN 的假新闻检测器的对抗性攻击
在较高的层面上,我们的问题可以被视为攻击基于 GNN 的节点分类,但具有模拟现实世界错误信息活动的实际约束。具体来说,攻击方法的目标是通过操纵受控的恶意社交媒体用户帐户来分享新帖子,从而改变目标社交帖子的 GNN 分类结果。请注意,我们假设攻击者 只能通过控制恶意用户共享新闻帖子来扰乱图表,而不能删除现有的共享新闻帖子。我们做出这个假设是因为在现实环境中,即使用户可以删除现有的共享帖子,共享关系的记录可能仍然存在于数据库中。考虑到平台使用的海量社交网络数据和多样化的假新闻检测器,我们假设未知目标 GNN 是在我们的问题设置中使用干净数据进行预训练的(即训练数据没有被对手毒害)。此外,我们假设我们了解检测器训练的 GNN 类型,但我们无权访问其模型参数。因此,我们的问题是对基于 GNN 的节点分类任务的灰盒躲避结构攻击。我们正式将攻击目标定义为:
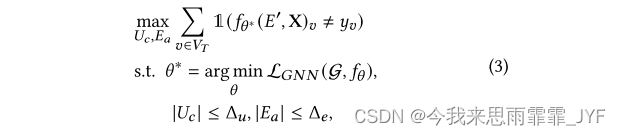
其中, U c {U_c} Uc、 E a {E_a} Ea 和 V T {V_T} VT 分别表示一组受控用户、操纵边和目标新闻帖子。 G G G 表示干净图, E ′ E' E′ 是扰动边的集合。 Δ u {\Delta _u} Δu 表示受控用户的预算, Δ e {\Delta _e} Δe 表示修改边的预算。上述对抗目标本质上是最大化目标帖子的误分类率。
方法
在实践中,错误信息活动是由协调的欺诈者操纵社交用户帐户来躲避检测而进行的。在本节中,我们首先阐明由现实世界的错误信息活动激发的攻击者的属性。然后,我们提出了用于探测基于 GNN 的假新闻检测器的鲁棒性的多智能体强化学习框架。
攻击者属性
攻击者知识。正如第 3.2 节中所介绍的,我们的攻击是 灰盒攻击,这意味着攻击者只了解基于 GNN 的分类器的架构,而不了解其模型内部结构(如权重或系数值)。为了攻击目标帖子的 GNN 分类结果,我们假设攻击者可以感知整个图,包括用户和帖子节点的特征和标签以及它们的连接。上述设置是实用的,因为社交媒体信息是公开访问的,并且鉴于错误信息研究中卓有成效的相关工作,攻击者可以轻松推断出节点特征和标签。
攻击者能力。为了尽可能模仿欺诈者的真实行为,我们将欺诈者控制的用户的能力(即 U c {U_c} Uc )定义如下:
直接攻击:如果 ( u , v ) ∉ E (u,v) \notin E (u,v)∈/E,则 u ∈ U c u \in {U_c} u∈Uc 直接共享 v ∈ V T v \in {V_T} v∈VT。在现实世界中,鉴于受控用户分享了许多来自可信来源的看似合法的帖子,如果用户分享该帖子,将有助于减轻虚假新闻帖子的可疑性。
间接攻击:对于 , u ∈ U c u \in {U_c} u∈Uc, v ∈ V T v \in {V_T} v∈VT, ( u , v ) ∈ E (u,v) \in E (u,v)∈E,我们通过控制 u u u 共享 v ′ ∉ V T v' \notin {V_T} v′∈/VT 来进行攻击。间接攻击利用 GNN 的邻居聚合机制,通过改变目标位置的邻域来对目标位置施加影响。在实践中,对于分享了假新闻目标帖子的受控用户,可以让受控用户分享来自可信来源的帖子,以误导 GNN 对目标假新闻帖子的预测。
请注意,正如前面 3.2 节中提到的,攻击者只被允许在用户节点和新闻发布节点之间添加边。
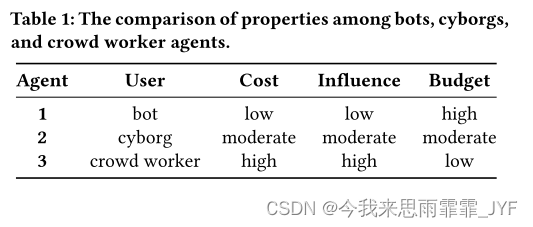
代理配置。现实世界的证据表明,多个恶意行为者团体参与了错误信息活动 [32,37,40]。除了单身人士单独行动外,大多数虚假信息活动都是由专业机构协调执行的,因为这样可以更快地达到活动目标,同时最大限度地利用现有资源。从对抗性攻击的角度来看,不同类型的受控用户账户对目标帖子和不同的预算有不同的影响。例如,机器人用户通常成本较低且预算较高。然而,这些机器人用户的历史记录很少;因此,每个机器人用户对目标帖子的影响有限[37]。拥有可信且丰富社会背景的众包工作者通常价格昂贵,但他们对目标帖子的影响力更强。
为了对上述不同的恶意行为者群体进行建模,以前的单代理强化学习框架不适用 [8, 43]。因此,我们利用 MARL,它不仅可以为每个组进行个性化配置,还可以帮助模拟不同组之间的协调行为。具体来说,我们根据[40]中介绍的恶意帐户定义了三个代理来控制三个不同的用户帐户组。我们根据用户分享的新闻数量来划分用户账户,图 2 显示了 Politifact 和 Gossipcop 数据集中用户分享的新闻数量分布。表 1 比较了以下代理的主要属性。
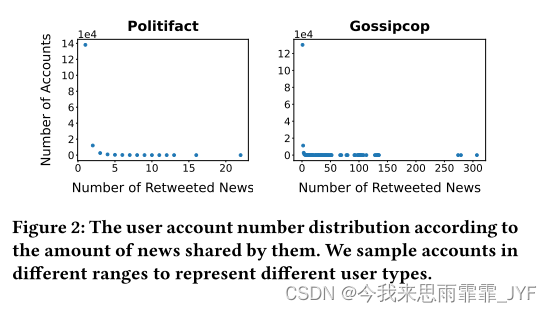
(1)代理1(社交机器人):由自动化程序注册并完全控制的社交机器人已被许多作品证明可以参与虚假新闻传播[2, 37]。第一个代理控制着机器用户,它成本低且预算高。我们随机选择数据集中仅有一个连接的用户来代表新创建的机器用户。
(2)代理2(Cyborg Users):根据[40],Cyborg 用户由人类注册并部分由自动化程序控制。人类和机器人之间功能的轻松切换为机器人提供了传播假新闻的独特机会。由于这些用户被伪装成人类,因此他们通常有更多的历史参与(即与其他帖子的联系)。在我们的数据集中,我们随机选择那些具有超过10个连接的用户来代表被 compromise 的用户。半机器人智能体的成本、预算和影响力介于其他两种智能体之间。
(3)代理 3(众包工作者):众包工作者通常成本很高,因为他们每次活动都会获得报酬。同时,他们的影响力也是最强的。我们选取拥有超过 20 个连接的用户,其中 100% 连接到真实的新闻帖子来代表众包工作者。
攻击框架
在现实世界中,上述每个代理都代表一个旨在影响假新闻分类结果的恶意行为者。给定一组目标新闻帖子 V T {V_T} VT,攻击过程可以建模为多智能体协作强化学习问题,其中所有智能体共同努力以最大化目标新闻帖子的错误分类率。图 3 说明了所提出的MARL算法的攻击过程。首先,不同智能体的动作由中心控制器聚合;然后,将聚合动作应用于由社交参与图和代理分类器组成的环境;分类器生成的更新状态和奖励最终被发送回每个代理以进行下一阶段的优化。在本小节中,我们首先定义 MARL 框架的每个组件,然后介绍如何利用深度 Q 学习进行优化。
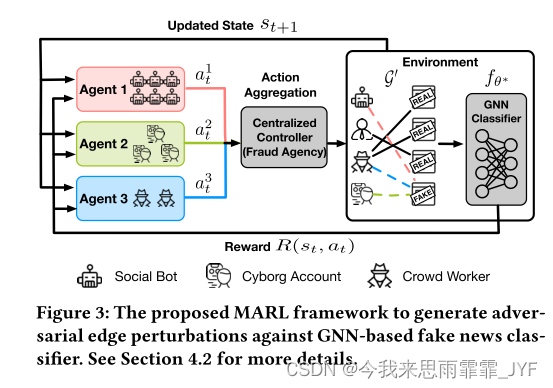
MARL 框架。与之前使用单代理 RL 的 GNN 攻击(可以建模为马尔可夫决策过程(MDP)[8, 43])不同,MARL 框架是一个马尔可夫博弈(MG)。我们正式定义 MG 及其组件如下:
定义 4.1. 一个马尔可夫博弈由一个元组定义
( N , S , { A i } i ∈ N , P , { R i } i ∈ N , Y ) (N,S,{\{ {A^i}\} _{i \in N}},P,{\{ {R^i}\} _{i \in N}},Y) (N,S,{Ai}i∈N,P,{Ri}i∈N,Y),其中 N = { 1 , . . . , N } N = \{ 1,...,N\} N={1,...,N} 表示 N N N 代理的集合, S S S 是观察到的状态空间所有智能体, A i {A^i} Ai 表示智能体 i i i 的动作空间。 P P P 是给定状态 s ∈ S s \in S s∈S 和动作 a ∈ A a \in A a∈A 的状态转移概率。 R R R 是奖励函数,决定从 ( s , a ) (s,a) (s,a) 转换到 s ′ s' s′ 后代理 i i i 收到的立即奖励。 γ \gamma γ 是长期奖励的折扣因子。
行动。如第 4.1.2 节中所定义,每个 u ∈ U c u \in {U_c} u∈Uc 只能根据其与 v ∈ V T v \in {V_T} v∈VT 的连接状态添加边。同时,每个代理根据第 4.1.3 节控制一组用户 U c i U_c^i Uci。我们使用 a t i ( u , v ) a_t^i(u,v) ati(u,v) 来表示在用户 u u u 和帖子 v v v 之间添加边的操作。因此,智能体 i i i 在时间 t t t 的动作空间为 a t i ∈ A i ⊆ U c i × V T a_t^i \in {A^i} \subseteq U_c^i \times {V_T} ati∈Ai⊆Uci×VT。我们使用集中控制器来聚合代理操作。具体而言,在每一轮中,最终的行动来自三种类型的代理,其比例是固定的,这个比例受到现实世界虚假信息宣传活动的启发。
状态。由于所有智能体协同工作,针对同一分类器 f f f 攻击同一组目标帖子 V T {V_T} VT,因此所有智能体在时间 t t t 时共享相同的状态,由 ( G t ′ , f ) ({G'_t},f) (Gt′,f) 表示,其中 G ′ G' G′ 是时间 t t t 时的扰动图。
奖励。作为灰盒攻击,我们的目标是改变目标分类器的分类结果。由于我们了解分类器的 GNN 架构,因此我们使用三个 GNN 模型(即 GAT、GCN 和 GraphSAGE)之一作为我们的替代目标分类器,并将其在 V T {V_T} VT 上的分类结果作为指导代理的奖励。请注意,奖励由合作环境下的所有代理共享。在所有代理根据其预算采取行动之后(即一个周期),每个代理对目标帖子 v ∈ V T v \in {V_T} v∈VT 的奖励为:
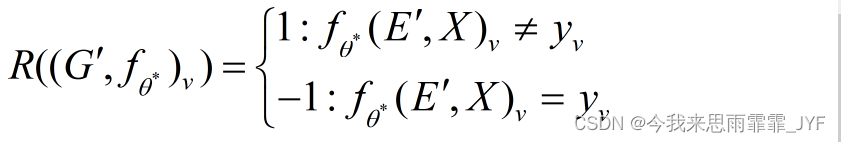
终止。每个代理根据其预算 Δ e i \Delta _e^i Δei 进行有限修改后,马尔可夫博弈停止。
深度 Q-Learning。为了解决上述马尔可夫博弈,我们需要找到最大化长期奖励期望值的最优策略。由于每个代理都有自己受控的用户帐户和预算,因此每个代理 i i i 应该有自己的策略 π i {\pi ^i} πi,即 a t i ∼ π i ( ⋅ ∣ s t ) a_t^i \sim {\pi ^i}( \cdot |{s_t}) ati∼πi(⋅∣st)。我们使用 Q 学习来学习由 Q 函数 Q i , ∗ ( s t , a t ) {Q^{i,*}}({s_t},{a_t}) Qi,∗(st,at) 参数化的最优策略 π i , ∗ {\pi ^{i,*}} πi,∗。智能体 i i i 的最佳 Q Q Q 值可以用以下贝尔曼方程表示:
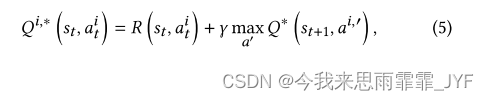
其中, a i , ′ {a^{i,'}} ai,′ 代表代理 i i i 基于状态 s t {s_t} st 的未来行动。上式提出了一种贪婪策略,其中代理 i i i 基于 s t {s_t} st 的最佳行动是最大化上述 Q Q Q 值的行动:
π i ( a t i ∣ s t ; Q i , ∗ ) = arg max Q i , ∗ a t i ( s t , a t i ) {\pi ^i}(a_t^i|{s_t};{Q^{i,*}}) = \mathop {\arg \max {Q^{i,*}}}\limits_{a_t^i} ({s_t},a_t^i) πi(ati∣st;Qi,∗)=atiargmaxQi,∗(st,ati)
对于每个目标帖子 v ∈ V T v \in {V_T} v∈VT,我们希望选择对 v v v 影响最大的受控用户 u ∈ U c u \in {U_c} u∈Uc 来改变 v v v 上的GNN分类结果。因此,使用 GNN 参数化 Q 函数可以帮助对每个动作的值进行建模。具体而言,我们首先使用两层GraphSAGE [15] 根据公式 (1) 获得当前状态 s t {s_t} st 中每个帖子节点 h v , t {h_{v,t}} hv,t 的嵌入。请注意,我们只考虑所有目标节点和受控用户帐户的 2 阶邻居,这可以减少状态和操作空间。对于时间 t t t 的代理 i i i,具有受控用户账户的嵌入 h u , t , u ∈ U c i {h_{u,t}},u \in U_c^i hu,t,u∈Uci ,以及目标节点 h v , t , v ∈ V T {h_{v,t}},v \in {V_T} hv,t,v∈VT, 动作 a t i ( u , v ) a_t^i(u,v) ati(u,v) 的 Q Q Q 值由以下方程计算:
Q i ( s t , a t i ( u , v ) ) = σ ( W 1 ( h u , t ) ) ⋅ σ ( W 2 ( h v , t ) ) {Q^i}({s_t},a_t^i(u,v)) = \sigma ({W^1}({h_{u,t}})) \cdot \sigma ({W^2}({h_{v,t}})) Qi(st,ati(u,v))=σ(W1(hu,t))⋅σ(W2(hv,t))
其中,两个线性层应用于两个末端节点嵌入,然后计算它们的点积,从而产生给定动作的 Q Q Q 值。
实验
正如4.1.2节中提到的,间接攻击不会直接修改用户节点和目标新闻节点之间的边,并且在实践中更有可能被攻击者用来逃避检测。在本节中,我们进行了一系列实验,以在更现实的间接设置下验证我们提出的框架的有效性,并分析影响 MARL 攻击性能的因素。然后,我们提出实验结果来比较直接攻击和间接攻击。最后,我们讨论了防御者可以使用的一些对策。具体来说,我们的目标是回答以下研究问题:
• RQ1:MARL 的性能与基线相比如何?
• RQ2:哪些因素影响MARL 的性能?
• RQ3:直接攻击与间接攻击相比如何?
• RQ4:针对攻击有哪些对策?
实验设置
在本小节中,我们介绍 MARL 间接攻击的实验设置。我们首先介绍实验所用的数据集、替代模型和基线方法,然后介绍实现细节。
数据集。我们从 FakeNewsNet [38] 数据集中提取了两个社交参与图,该数据集由虚假和真实新闻帖子的元数据及其在 Twitter 上的参与用户组成,来自两个事实检查来源:Politifact 和 Gossipcop。按照 [10] 的方法,我们将用户历史推文的 Glove 300D [33] 嵌入作为其特征,并将社交帖子关联的新闻内容的 Glove 嵌入作为其特征。请注意,我们的攻击操作受控用户来分享帖子;由于用户更改的边的数量在紧张的预算之内,因此我们假设所有节点特征在攻击过程中都保持不变。
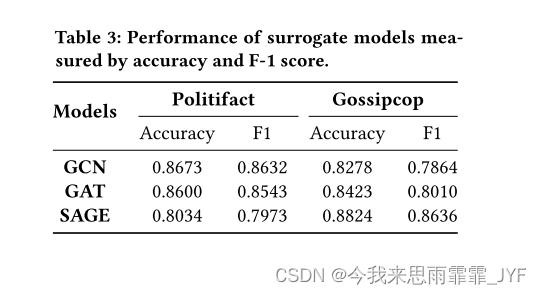
替代模型。在灰盒设置下,攻击者仅拥有有关被攻击模型的架构的信息。因此,攻击必须在与目标模型具有相同 GNN 架构的替代模型 M M M 上执行。对于基于 GNN 的假新闻检测器,我们包括三个经典的 GNN 模型。具体来说,我们使用图卷积网络[22]、图注意力网络[45]和GraphSAGE[15]作为我们的 M M M。表 3 显示了这些替代模型在 Politifact 和 Gossipcop 上的表现。我们训练这些模型以确保它们在两个数据集上具有相似的性能。这样我们就可以比较地衡量MARL的攻击性能。
基线攻击方法。由于攻击者的能力有限,并且受控用户和目标帖子的候选者都受到限制,我们不能将基于特征和梯度的攻击[50]作为基线。为了比较所提出的 MARL 框架的有效性,我们将其与以下基线进行比较:
随机边(RD-Edge):这是一个简单的基线,随机选择受控用户和目标帖子来添加边,直到满足预算。
随机节点(RD-Node):该基线将新的用户节点注入到图中,并将它们与目标新闻节点连接起来。
单代理 RL:为了证明 MARL 的有效性,我们通过将攻击者限制为单一类型的代理来创建此基线。具体而言,我们有三个基线模型,分别命名为 RL-A1(Bot)、RL-A2(Cyborg)和 RL-A3(Crowd Worker)。
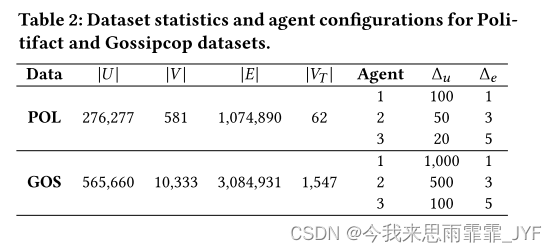
预算和目标选择标准,关于 Politifact 数据集,我们从表1中随机抽样了100个机器人代理、50个半机器人代理和20个众包工作者代理。对于 Gossipcop 数据集,我们从中随机抽样了1,000个机器人代理、500个半机器人代理和100个众包工作者代理。
实施细节,对于 Random-Edge 方法,我们基于代理节点的度将攻击代理和新闻目标之间建立边。具体而言,我们随机连接机器人代理和 1 个新闻目标,半机器人代理和 3 个新闻目标,众包工作者代理和 5 个新闻目标。对于随机节点方法,我们为三种代理类型中的每一种添加 5 个用户节点。我们通过从每种类型的代理中随机抽样20个节点,然后取它们的嵌入的平均值来为每个新注入节点生成嵌入。我们以与 RandomEdge 方法相同的方式连接生成的用户节点和目标新闻节点。我们使用 PyG [13] 来实现所有 GNN 算法。 MARL算法是基于[8]提供的RL-S2V代码实现的。我们的代码和数据是公开的(https://github.com/hwang219/AttackFakeNews)。
RQ1:MARL 的性能
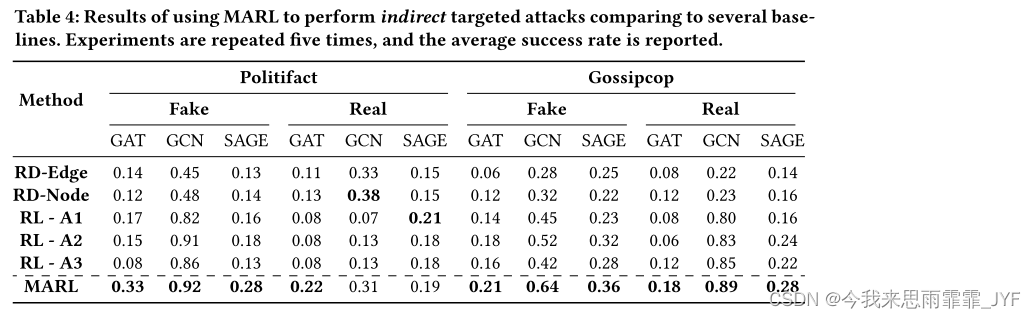
由于攻击者在实践中更可能使用间接攻击而不是直接攻击来逃避检测,因此我们在 Politifact 和 Gossipcop 中研究了针对假新闻和真实新闻的有针对性的间接攻击。表 4 报告了 MARL 与基线相比的攻击性能。从表中,我们得出以下观察结果:
- 我们可以看到 MARL 提高了两个数据集上假新闻的整体攻击性能。与 RandomEdge 基线相比,MARL 对于 Politifact 上的 [GAT, GCN, GraphSAGE] 分别提高了有针对性的虚假新闻攻击的成功率 [57.6%, 51.1%, 53.6%],在 Gossipcop 上分别提高了 [250%, 128.6%, 44%]。
- 我们发现靠近决策边界的新闻帖子更容易受到攻击。例如,当我们将落在[0.5,0.7]决策边界内的假新闻与决策边界之外的假新闻的间接攻击的成功率进行比较时,我们发现GAT 检测器在 Politifact 数据集上攻击假新闻的成功率从0.18增加到0.33。
- 另一个有趣的发现是,与 GAT 和 GraphSAGE 相比,GCN 对边扰动更敏感。攻击者只需向图中添加少量边,就可以在 GCN 上获得相当好的性能。例如,在攻击 Politifact 上的假新闻时,我们只需添加 210 个边就可以达到 0.48 的成功率。相比之下,在相同的攻击预算下,GAT 和 GraphSAGE 检测器的成功率分别为 0.12 和 0.14,远低于 GCN。之前的工作 [7, 8] 也表明,由于 GCN 的加权平均聚合方法的故障点较低,因此很容易受到结构性对抗性攻击。
RQ2:攻击性能分析
在本小节中,我们将回答 RQ2 并提供有关影响 MARL 攻击性能的因素的见解。具体来说,我们提供基于代理类型和新闻类型的分析。
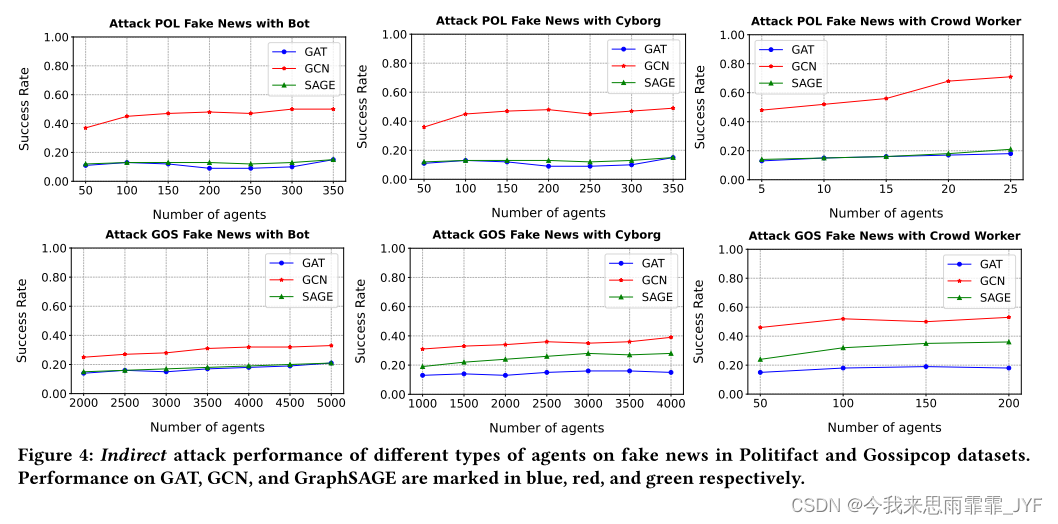
代理类型。图 4 显示了单代理 RL 的消融研究结果。具体来说,我们使用 RL-A1、RL-A2 和 RL-A3 方法对 Politifact 和 Gossipcop 数据集中的假新闻进行有针对性的间接攻击,并通过使用更多代理来增加攻击预算。我们提出以下观察:
- 对于所有三种类型的代理,总体攻击性能随着攻击预算的增加而提高。
- 达到阈值后,性能增益会减慢。因此,攻击者需要选择最佳数量的代理来执行间接攻击。
- 在相同数量的攻击预算下,群体工作者代理在所有三个 GNN 上都比机器人和机器人代理取得了更好的性能。这是预料之中的,因为众包代理具有更强的影响力,并且他们的社交帖子与真实新闻相关。因此,他们对假新闻的影响力更大。
基于上述观察,我们将用户节点分为“好”组和“坏”组。具体来说,我们将分享的新闻中超过 80% 的假新闻的用户归为“坏”组,将分享的新闻中假新闻的比例低于 20% 的用户归为“好”组。
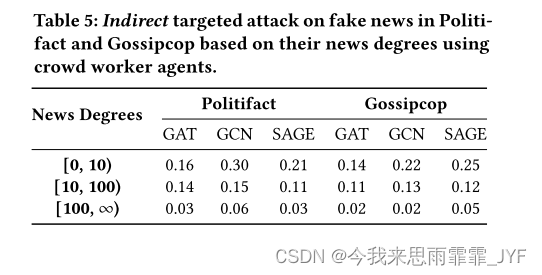
新闻类型。直观地,我们猜测具有更高度数的新闻帖子节点比度数较低的节点更具抗攻击性。为了验证这个假设,我们根据节点度来攻击 Politifact 和 Gossipcop 中不同组的假新闻。在本实验中,我们分别为 Politifact 使用 10 个众包代理,为 Gossipcop 使用 50 个众包代理。正如表 5 所示,在所有三种GNN中,攻击具有较高度数的新闻明显更为困难。即使在最容易受到攻击的GNN(即GCN)上,与度数小于 10 的新闻相比,MARL在攻击度数大于 100 的虚假新闻时的性能显著下降(Politifact上下降80%,Gossipcop上下降90.9%)。另一个观察结果是,对于度数在 10 到 100 之间的新闻,GAT 比 GCN 和 GraphSAGE 更稳健。如表 5 所示,当新闻度从小于 10 增加到小于 100 时,GAT 在 Politifact 和 Gossipcop 上的性能仅分别下降了 12.5% 和 21.4%。而 GCN 和 GraphSAGE 在两个数据集上的性能下降几乎减半。这可能是由于 GAT 的注意力机制使其对程度变化不太敏感。
RQ3:直接与间接
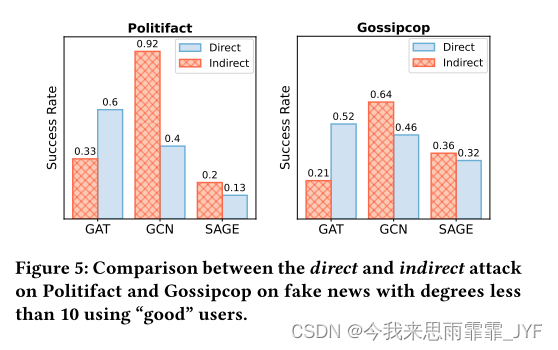
回想一下4.1.2节,直接攻击意味着攻击者修改从用户节点到目标新闻节点直接链接的边。尽管在现实场景中直接攻击更为明显,由于对图结构的直接扰动,它们可能比间接攻击实现更好的性能。对于这个实验,在Politifact上我们对25个好用户进行了采样,在Gossipcop上对250个好用户进行了采样,以在两个数据集中执行有针对性的对虚假新闻的攻击。图5显示了直接攻击和间接攻击之间的比较。
RQ4:针对攻击的对策
根据我们的实验结果,我们从两个角度讨论了针对操纵新闻社交参与的欺诈者的对策。1)从机器学习安全的角度来看,在防御图对抗攻击方面有丰富的研究工作[42]。可以利用对抗训练 [12]、异常检测 [11] 和强大的 GNN 模型 [14, 20] 等方法来防御攻击。2)从实践角度来看,社交媒体平台应该对“机器人”用户和看似“好”用户给予同等重视。正如实验所示,攻击者可以利用用户良好的发帖历史对假新闻进行成功的定向攻击,从而破坏基于 GNN 的检测器。由于间接攻击对许多 GNN 检测器有效,这表明平台应该监控与目标新闻相关的账户的更多参与活动,而不是目标新闻本身。实验结果还表明,不存在普遍鲁棒的模型,促使平台采用多样化的信任和安全模型。
结论
在本文中,我们的目的是了解基于图神经网络的假新闻检测器在结构性对抗攻击下的脆弱性。据我们所知,这是第一个攻击基于 GNN 的假新闻检测器的工作。本文旨在就如何开发更强大的基于 GNN 的假新闻检测器来应对未来的对抗性攻击提供见解。我们利用多代理强化学习框架来模仿现实世界错误信息活动中欺诈者的攻击行为。我们的实验结果表明,与我们的基线相比,MARL 提高了整体攻击性能,并且对于基于 GCN 的检测器非常有效。
尽管我们从实验中得到了一些有希望的结果,但本文有两个主要局限性:1)这项工作仅采用简单的启发式方法来选择用户进行操作聚合。2)Q 网络的搜索空间相当大,导致像 Gossipcop 这样的较大数据集上的计算成本很高。因此,有几个有趣的方向需要进一步研究。第一个是自动化选择最佳代理以进行操作聚合的过程。二是有效减少深度Q网络的搜索空间。最后,我们在本文中使用了普通的 MARL 框架。为这项任务探索一个更复杂的 MARL 框架将会很有趣。