提升遮挡场景检测鲁棒性)
# 前言
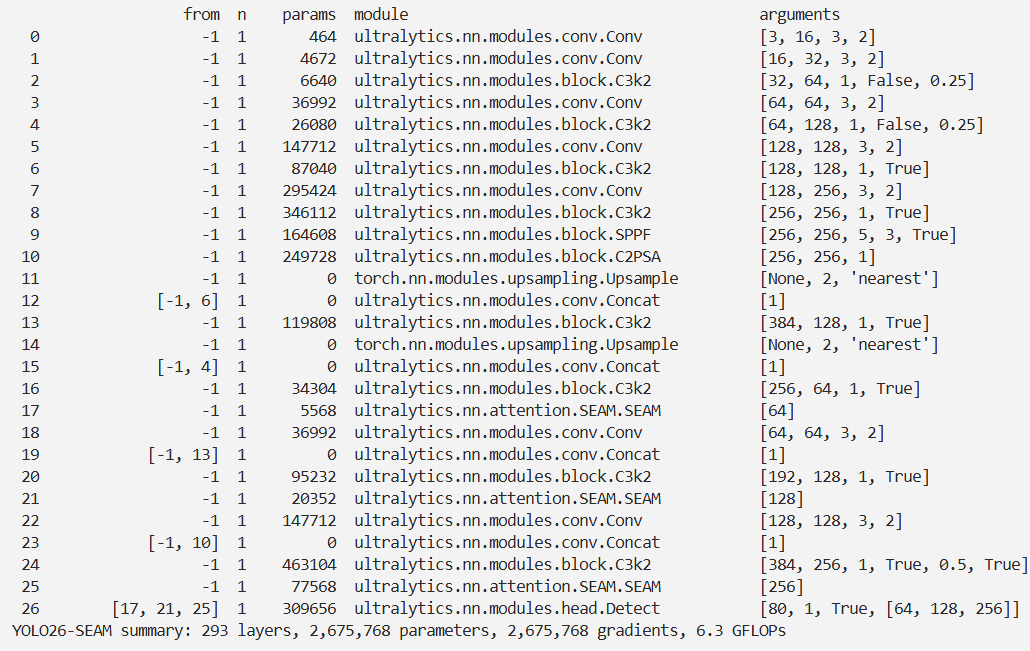
本文介绍了分离与增强注意力模块(SEAM)在YOLO26中的结合应用。SEAM模块旨在增强面部特征学习能力,特别是处理面部遮挡问题。它采用多头注意力机制强调面部区域、抑制背景区域,第一部分使用深度可分离卷积减少参数并学习通道重要性,通过1x1卷积增强通道联系,利用两层全连接网络融合通道信息,经指数归一化后作为注意力权重与原始特征相乘。我们将SEAM集成到YOLO26的检测头中,并进行相关注册和配置。实验表明,该方法有助于提升模型检测性能。
文章目录: YOLO26改进大全:卷积层、轻量化、注意力机制、损失函数、Backbone、SPPF、Neck、检测头全方位优化汇总
专栏链接: YOLO26改进专栏
@
- 介绍
- 摘要
- 文章链接
- 基本原理
- 核心代码
- 实验
- 脚本
- 结果
介绍
摘要
近年来,基于深度学习的人脸检测算法取得了重大进展,这些算法通常可划分为两类,即如Faster R - CNN的二阶段检测器和如YOLO的单阶段检测器。鉴于在精度与速度之间实现了更优平衡,单阶段检测器已在众多应用中得到广泛应用。在本文中,我们提出了一种基于单阶段检测器YOLOv5的实时人脸检测器,命名为YOLO - FaceV2。我们设计了一个名为RFE的感受野增强模块,用以增强小脸部的感受野,并采用NWD Loss来弥补交并比(IoU)对微小物体位置偏差的敏感性。针对面部遮挡问题,我们提出了一个名为SEAM的注意力模块,并引入排斥损失来加以解决。此外,我们运用一个名为Slide的权重函数来解决简单样本与困难样本之间的不平衡问题,并利用有效感受野的信息来设计锚点。在WiderFace数据集上的实验结果表明,我们的面部检测器性能超越了YOLO及其变体,在简单、中等和困难所有子集中均有体现。源代码可在https://github.com/Krasjet - Yu/YOLO - FaceV2获取。
文章链接
论文地址:论文地址
代码地址:代码地址
基本原理
SEAM(Separated and Enhanced Attention Module)是YOLO-FaceV2中引入的一个模块,旨在增强面部特征的学习能力,特别是在面部遮挡的情况下。
- 多头注意力机制:SEAM模块采用了多头注意力机制,旨在强调图像中的面部区域,同时抑制背景区域。这种机制使得模型能够更好地关注到重要的面部特征,从而提高检测的准确性。
- 深度可分离卷积:SEAM的第一部分使用深度可分离卷积,这种卷积方式是逐通道进行的,能够有效减少参数数量,同时学习不同通道的重要性。通过这种方式,模型能够提取出更具代表性的特征。
- 通道关系的学习:虽然深度可分离卷积在减少参数方面表现良好,但它可能忽略通道之间的信息关系。为了解决这个问题,SEAM在深度卷积的输出后,使用1x1卷积进行点对点的组合,以增强通道之间的联系。这一过程有助于模型在遮挡场景中更好地理解被遮挡面部与未遮挡面部之间的关系。
- 全连接网络的融合:在通道关系学习之后,SEAM使用一个两层的全连接网络来融合每个通道的信息。这一过程进一步加强了通道之间的连接,使得模型能够更有效地处理面部遮挡问题。
- 指数归一化:SEAM模块的输出经过指数函数处理,将值范围从[0, 1]扩展到[1, e]。这种指数归一化提供了一种单调映射关系,使得结果对位置误差更加宽容,从而提高了模型的鲁棒性。
- 注意力机制的应用:最后,SEAM模块的输出被用作注意力权重,与原始特征相乘。这一过程使得模型能够更有效地处理面部遮挡,提高了对被遮挡面部的响应能力。
核心代码
class SEAM(nn.Module):def __init__(self, c1, c2, n, reduction=16):super(SEAM, self).__init__()if c1 != c2:c2 = c1self.DCovN = nn.Sequential(# nn.Conv2d(c1, c2, kernel_size=3, stride=1, padding=1, groups=c1),# nn.GELU(),# nn.BatchNorm2d(c2),*[nn.Sequential(Residual(nn.Sequential(nn.Conv2d(in_channels=c2, out_channels=c2, kernel_size=3, stride=1, padding=1, groups=c2),nn.GELU(),nn.BatchNorm2d(c2))),nn.Conv2d(in_channels=c2, out_channels=c2, kernel_size=1, stride=1, padding=0, groups=1),nn.GELU(),nn.BatchNorm2d(c2)) for i in range(n)])self.avg_pool = torch.nn.AdaptiveAvgPool2d(1)self.fc = nn.Sequential(nn.Linear(c2, c2 // reduction, bias=False),nn.ReLU(inplace=True),nn.Linear(c2 // reduction, c2, bias=False),nn.Sigmoid())self._initialize_weights()# self.initialize_layer(self.avg_pool)self.initialize_layer(self.fc)def forward(self, x):b, c, _, _ = x.size()y = self.DCovN(x)y = self.avg_pool(y).view(b, c)y = self.fc(y).view(b, c, 1, 1)y = torch.exp(y)return x * y.expand_as(x)def _initialize_weights(self):for m in self.modules():if isinstance(m, nn.Conv2d):nn.init.xavier_uniform_(m.weight, gain=1)elif isinstance(m, nn.BatchNorm2d):nn.init.constant_(m.weight, 1)nn.init.constant_(m.bias, 0)def initialize_layer(self, layer):if isinstance(layer, (nn.Conv2d, nn.Linear)):torch.nn.init.normal_(layer.weight, mean=0., std=0.001)if layer.bias is not None:torch.nn.init.constant_(layer.bias, 0)实验
脚本
import warnings
warnings.filterwarnings('ignore')
from ultralytics import YOLOif __name__ == '__main__':
#     修改为自己的配置文件地址model = YOLO('./ultralytics/cfg/models/26/yolo26-SEAM.yaml')
#     修改为自己的数据集地址model.train(data='./ultralytics/cfg/datasets/coco8.yaml',cache=False,imgsz=640,epochs=10,single_cls=False,  # 是否是单类别检测batch=8,close_mosaic=10,workers=0,optimizer='MuSGD',amp=True,project='runs/train',name='yolo26-SEAM',)
结果