符号说明:
数据集:\(D = \{(x_1, y_1), (x_2, y_2), \cdots, (x_N, y_N)\} \quad\)
x和y的取值范围:\(x_i \in \mathbb{R}^p \quad y_i \in \mathbb{R} \quad i = 1, 2, \cdots, N\)
\(X = \begin{pmatrix}
x_1^T \\
x_2^T \\
\vdots \\
x_N^T
\end{pmatrix} = \begin{pmatrix}
x_{11} & x_{12} & \cdots & x_{1p} \\
x_{21} & x_{22} & \cdots & x_{2p} \\
\vdots & \vdots & \ddots & \vdots \\
x_{N1} & x_{N2} & \cdots & x_{NP}
\end{pmatrix}_{N \times P}\),\(Y = \begin{pmatrix}
y_1 \\
y_2 \\
\vdots \\
y_N
\end{pmatrix}_{N \times 1}\)
最小二乘法的几何意义
对最小二乘法公式进行推导:
\[\begin{aligned}
L(W)&=\sum_{i=1}^N(W^Tx_i-y_i)^2\\&=(W^Tx_1-y_1\quad W^Tx_2-y_2\quad\cdots\quad W^Tx_N-y_N)\begin{pmatrix}(W^Tx_1-y_1)^T\\(W^Tx_2-y_2)^T\\\vdots\\(W^Tx_N-y_N)^T\end{pmatrix}\\&=[W^T\begin{pmatrix}x_1&x_2&\cdots&x_N\end{pmatrix}-\begin{pmatrix}y_1&y_2&\cdots&y_N\end{pmatrix}]\begin{pmatrix}x_1^TW-y_1^T\\x_2^TW-y_2^T\\\vdots\\x_N^TW-y_N^T\end{pmatrix}\\&=(W^TX^T-Y^T)(XW-Y)\\&=W^TX^TXW-W^TX^TY-Y^TXW+Y^TY\\&=W^TX^TXW-2W^TX^TY+Y^TY
\end{aligned}\]
令\(\frac{\partial L(W)}{\partial W}=2X^{T}XW-2X^{T}Y=0\),则\(W=(X^TX)^{-1}X^TY\)
- 伪逆:\(A^+=(X^T X)^{-1} X^T\)
- 左逆:\(X_{left}^{-1}=(X^T X)^{-1} X^T\),满足\(X_{left}^{-1} \cdot X = I\)
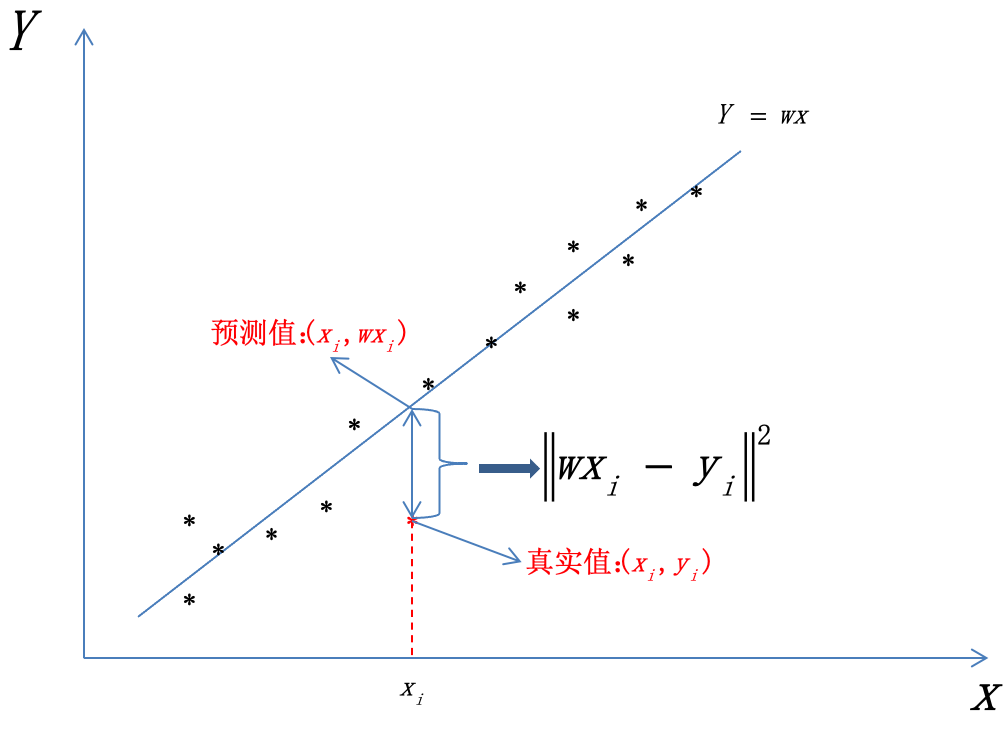
从每一个数据点的误差来看
从投影角度来看
\[\begin{aligned}
X_{N\times p}W_{p\times1}&=\begin{pmatrix}x_{11}&x_{12}&\cdots&x_{1p}\\x_{21}&x_{22}&\cdots&x_{2p}\\\vdots&\vdots&\ddots&\vdots\\x_{N1}&x_{N2}&\cdots&x_{NP}\end{pmatrix}\begin{pmatrix}w_1\\w_2\\\vdots\\w_p\end{pmatrix}\\&=\begin{pmatrix}x_{11}w_1+x_{12}w_2+\cdots+x_{1p}w_p\\x_{21}w_1+x_{22}w_2+\cdots+x_{2p}w_p\\\vdots\\x_{N1}w_1+x_{N2}w_2+\cdots+x_{Np}w_p\end{pmatrix}\\&=\left(w_1\begin{pmatrix}x_{11}\\x_{21}\\\vdots\\x_{N1}\end{pmatrix}+w_2\begin{pmatrix}x_{12}\\x_{22}\\\vdots\\x_{N2}\end{pmatrix}+\cdots+w_p\begin{pmatrix}x_{1p}\\x_{2p}\\\vdots\\x_{Np}\end{pmatrix}\right)
\end{aligned}
\]
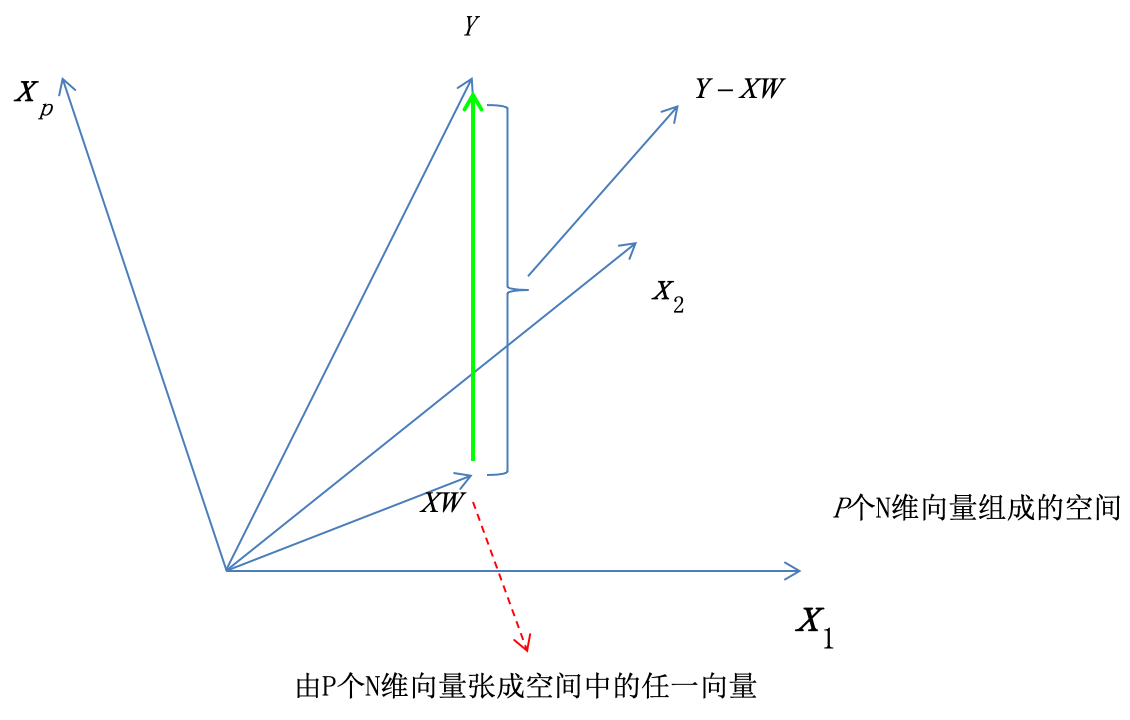
因此可以将\(X\)中每一列看作一个向量,\(XW\)便是\(W\)对\(X\)列向量的线性组合。想象Y在一个更高维的空间中, \(Y\) 无法由 \(X\) 的列向量线性表示,即 \(Y\) 不属于 \(X\) 的列空间。因此需要找到 \(Y\) 在 \(X\) 列空间上的投影,因为该投影与Y最为接近。
最小二乘法-概率视角-高斯噪声-MLE
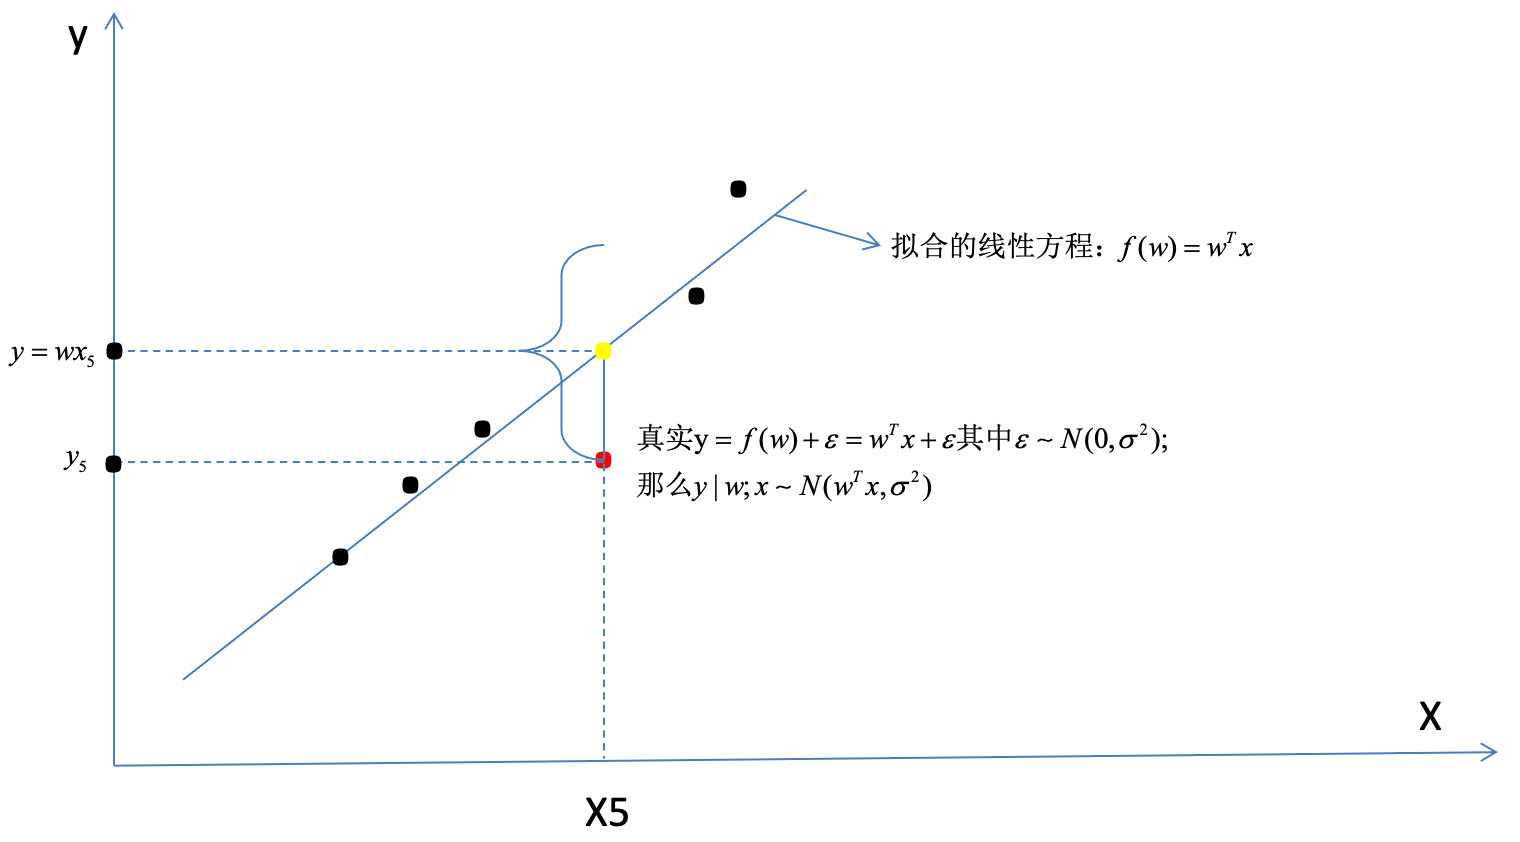
假设噪声 ε ~ N(0, σ²),则\(y = f(W) + ε = W^T X + ε\),此处把 \(W^T X\) 看成常数,因为当 W 固定后,\(W^T X\) 是固定值,因此 \(y|X, W \sim N(W^T X, σ^2)\),则可得到:
\[p(y|X, W) = \frac{1}{\sqrt{2πσ}} \exp(-\frac{(y - W^T X)^2}{2σ^2})
\]
接下来使用 MLE(最大似然估计)求解最优 W:
\[\begin{aligned}
L(W)&=\log p(y|X,W)\\&=\log\prod_{i=1}^Np(y_i|x_i,W)\\&=\sum_{i=1}^N\log p(y_i|x_i,W)\\&=\sum_{i=1}^N\log(\frac{1}{\sqrt{2\pi}\sigma}\exp(-\frac{(y_i-W^Tx_i)^2}{2\sigma^2}))\\&=\sum_{i=1}^N\log\frac{1}{\sqrt{2\pi}\sigma}-\frac{(y_i-W^Tx_i)^2}{2\sigma^2}\\
\hat{\boldsymbol{W}}&=argmaxL(W)\\&=argmax\sum_{W}^N\log\frac{1}{\sqrt{2\pi}\sigma}-\frac{(y_i-W^Tx_i)^2}{2\sigma^2}\\&=argmax\sum_{i=1}^N-\frac{(y_i-W^Tx_i)^2}{2\sigma^2}\\&=argmin_W\sum_{i=1}^N\frac{(y_i-W^Tx_i)^2}{2\sigma^2}\\&=argmin_W\sum_{i=1}^N{(y_i-W^Tx_i)^2}\end{aligned}
\]
贝叶斯角度-高斯噪声高斯先验-MAP
\[\begin{aligned}
\hat{\boldsymbol{W}}&=arg \max_{W}p(W|y)\\&=argmax_W\frac{p(y|W)p(W)}{p(y)}\\&=arg \max_W p(y|W)p(W)\\&=arg \max_W \log\left\{p(y|W)p(W)\right\}\\&=arg \max_{W}\log{\{\frac{1}{\sqrt{2\pi}\sigma}\exp{\{-\frac{(y-W^TX)^2}{2\sigma^2}\}}\frac{1}{\sqrt{2\pi}\sigma_0}\exp{\{-\frac{\|W\|^2}{2\sigma_0^2}\}}\}}\\&=arg \max_W\log{(\frac{1}{\sqrt{2\pi}\sigma}\frac{1}{\sqrt{2\pi}\sigma_0})}-\frac{(y-W^TX)^2}{2\sigma^2}-\frac{\|W\|^2}{2\sigma_0^2}\\&=arg \max_W-\frac{(y-W^TX)^2}{2\sigma^2}-\frac{\|W\|^2}{2\sigma_0^2}\\&=argmin_W\frac{(y-W^TX)^2}{2\sigma^2}+\frac{\|W\|^2}{2\sigma_0^2}\\&=argmin_W(y-W^TX)^2+\frac{\sigma^2}{\sigma_0^2}\|W\|^2\\&=argmin_W\sum_{i=1}^N(y_i-W^Tx_i)^2+\frac{\sigma^2}{\sigma_0^2}\|W\|^2
\end{aligned}
\]
观察上式结果,其与加了Ridge正则化的Loss Function一致:\(J(W)=\sum\left\|W^Tx_i-y_i\right\|^2+\lambda W^TW\),其中\(\lambda=\frac{\sigma^2}{\sigma_0^2}\)