

前言
ClickHouse是俄罗斯的Yandex于2016年开源的列式存储数据库 DBMS ),使用C语言编写,主要用于在线分析处理查询( OLAP ),能够使用SQL查询实时生成分析数据报告。列式存储:数据按列进行存储,这使得 ClickHouse 能够高效地处理聚合查询和分析操作;高性能:ClickHouse 被设计用于快速查询和分析大规模数据,因此具有出色的性能。分布式架构:支持分布式部署,可以轻松地扩展到多个节点,以处理大量数据和并行查询。实时数据插入:支持实时数据的快速插入,并能在不影响查询性能的情况下进行数据更新。灵活的数据格式支持:支持多种数据格式,包括 JSON、CSV 等,同时也支持压缩和加密。
ClickHouse主要用于数据分析,ClickHouse 适用于各种数据分析场景,包括业务智能、报告、仪表板等;日志分析:由于其高性能和实时数据插入功能,ClickHouse 可以用于大规模日志分析;时序数据处理:适用于处理时序数据,例如传感器数据、监控数据等;实时报表:能够支持实时数据的快速查询和分析,适用于生成实时报表和统计数据。
本节内容主要是关于如何搭建ClickHouse数据库,实现Clickhouse数据库的部署安装。
| hadoop101 | hadoop102 | hadoop103 |
|---|---|---|
| clickhouse | clickhouse | clickhouse |
| zookeeper | zookeeper | zookeeper |
正文
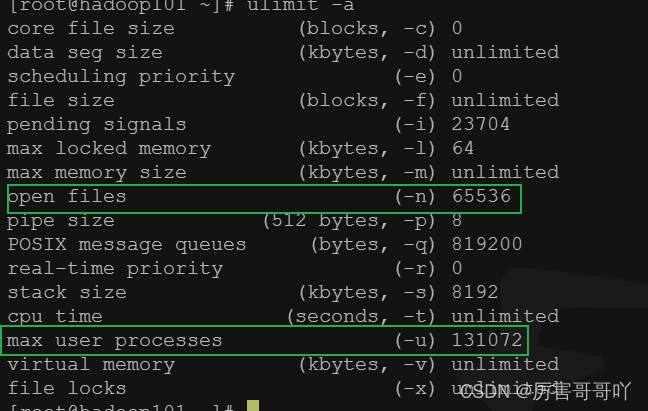
①配置centos系统文件数限制,避免文件句柄数不够使用
- 在/etc/security/limits.conf中增加句柄数的配置
* soft nofile 65536
* hard nofile 65536
* soft nproc 131072
* hard nproc 131072
- 在/etc/security/limits.d/20-nproc.conf的配置中也增加以上句柄数的配置
- 查看配置修改是否生效:ulimit -a
- 将上述俩个配置文件分发到hadoop102和hadoop103服务器上,使配置生效



② 分别在hadoop101、hadoop102、hadoop103服务器安装系统依赖
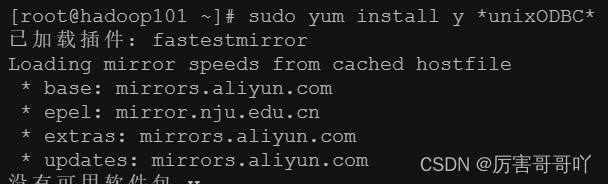
- 使用yum安装依赖
sudo yum install y libtool
sudo yum install y *unixODBC*
sudo yum install -y yum-utils
sudo yum-config-manager --add-repo https://packages.clickhouse.com/rpm/clickhouse.repo



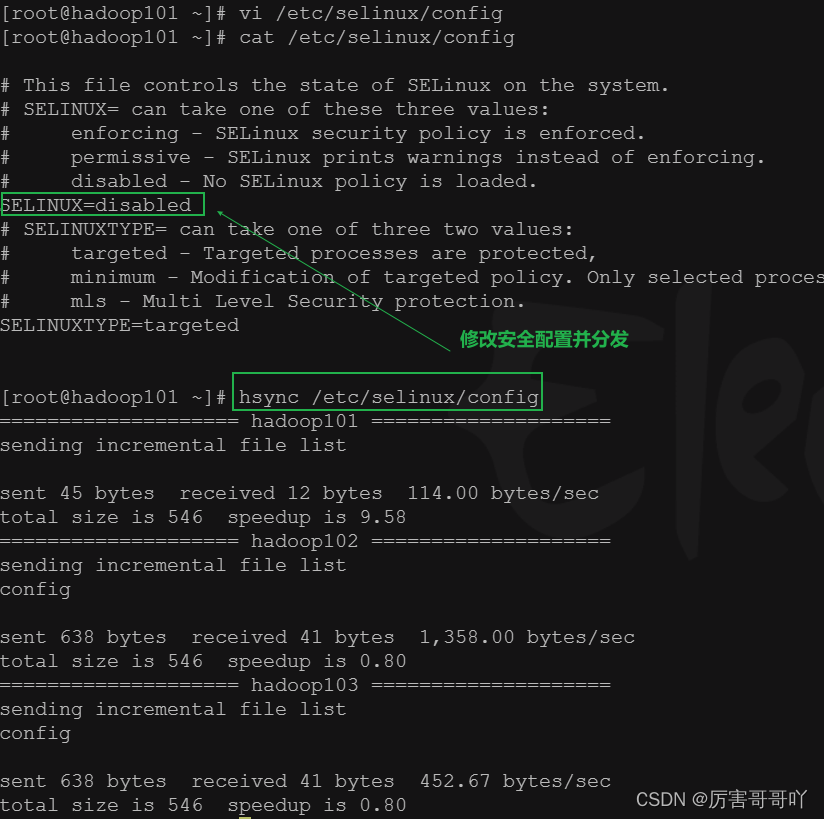
③ 关闭系统selinux安全配置,并重启hadoop101、hadoop102、hadoop103系统
- 修改/etc/selinux/config中的SELINUX=disabled,并重启系统reboot
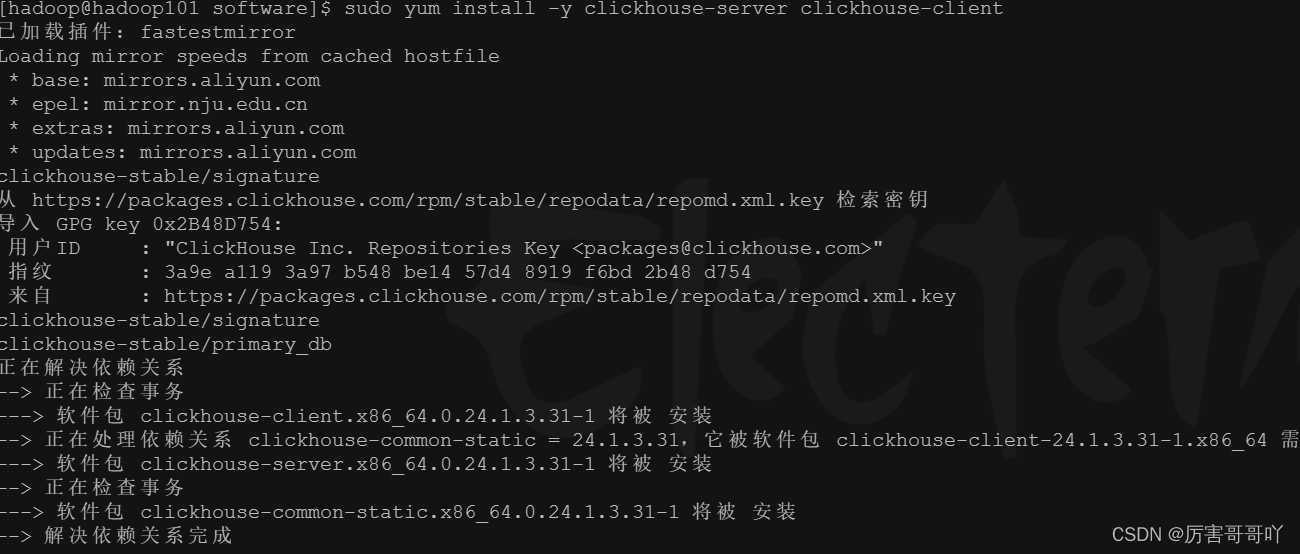
④使用官方推荐的方式,使用yum命令分别在hadoop101、hadoop102、hadoop103安装clickhouse服务端和客户端
- 命令:sudo yum install -y clickhouse-server clickhouse-client
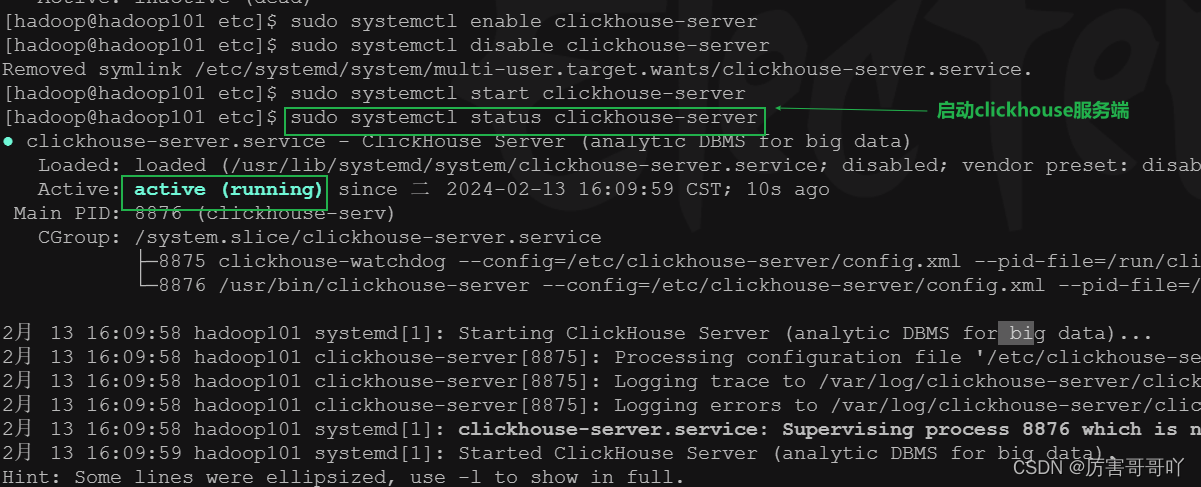
⑤启动clickhouse服务端并查看状态
- 命令:
//设置为开机自启动
sudo systemctl enable clickhouse-server
//取消开机自启动
sudo systemctl disable clickhouse-server
//启动clickhouse-server服务端
sudo systemctl start clickhouse-server
//查看clickhouse-server服务端状态
sudo systemctl status clickhouse-server
//停止clickhouse-server服务端
sudo systemctl stop clickhouse-server
⑥使用clickhouse客户端连接clickhouse数据库
- 命令:clickhouse-client -m

⑦修改clickhouse的配置文件/etc/clickhouse-server/config.xml,使得hadoop集群间可以相互访问
- 将<listen_host>::</listen_host> 配置打开,然后重启clickhouse服务
- 重启clickhouse服务
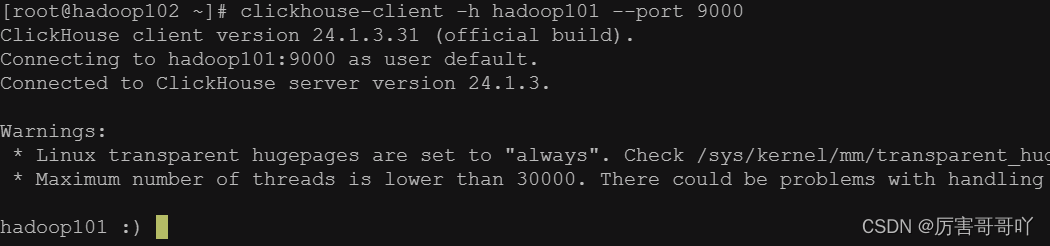
- 使用hadoop102的客户端连接hadoop101的服务


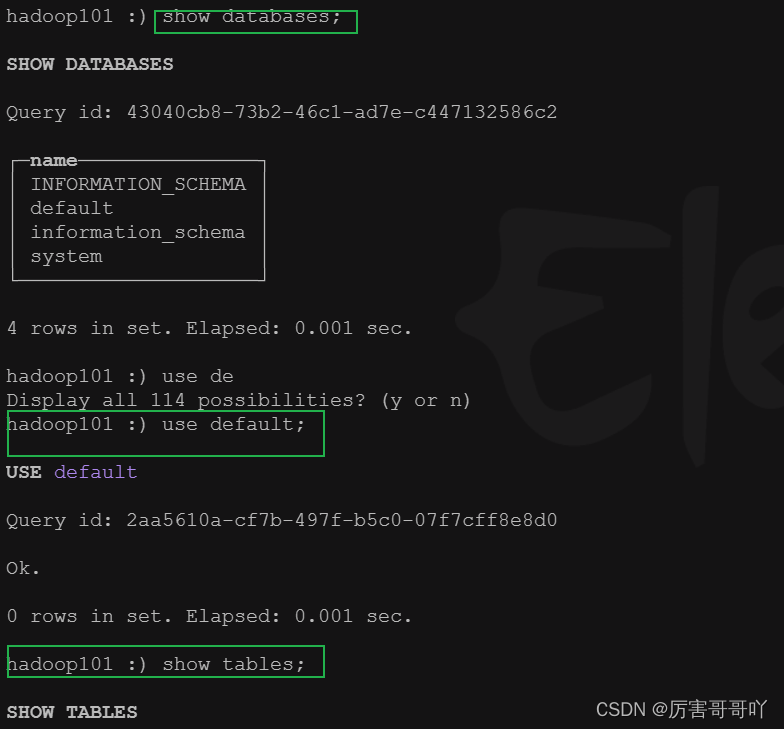
⑧验证clickhouse数据库是否可以正常使用
⑨配置副本:在hadoop101、hadoop102、hadoop103配置zookeeper,互为副本保证clickhouse数据库的高可用
- 在配置文件/etc/clickhouse-server/config.xml中配置zookeeper连接信息
 <zookeeper><node><host>hadoop101</host><port>2181</port></node><node><host>hadoop102</host><port>2181</port></node><node><host>hadoop103</host><port>2181</port></node>
</zookeeper>
- 分发配置文件config.xml到hadoop102、hadoop103服务器
- 启动zookeeper服务器
- 重启clickhouse数据库服务器


⑩验证副本配置是否生效
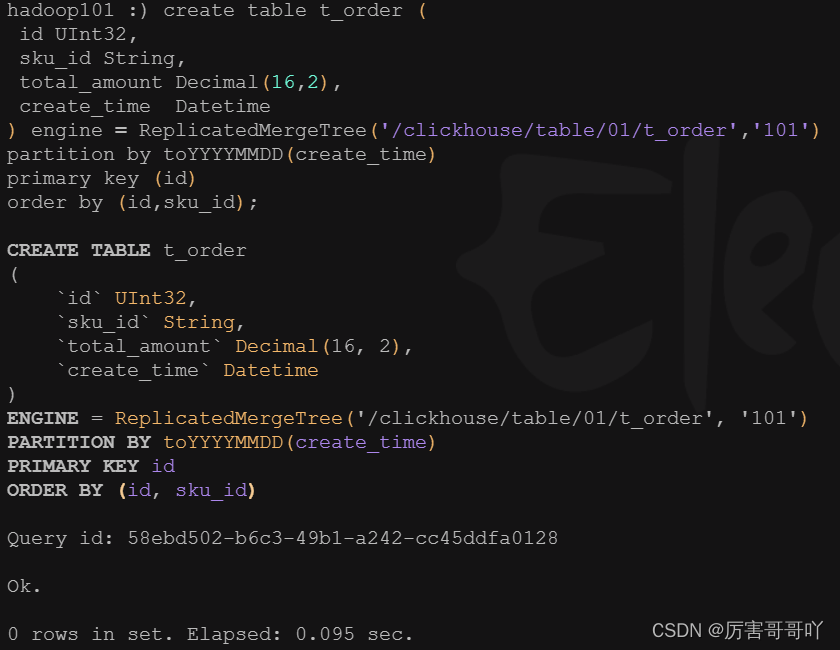
- 分别在hadoop101、hadoop102、hadoop103服务器创建表t_order
# hadoop101
create table t_order (id UInt32, sku_id String,total_amount Decimal(16,2), create_time  Datetime
) engine = ReplicatedMergeTree('/clickhouse/table/01/t_order','101')
partition by toYYYYMMDD(create_time)
primary key (id)
order by (id,sku_id);# hadoop102
create table t_order (id UInt32, sku_id String,total_amount Decimal(16,2), create_time  Datetime
) engine = ReplicatedMergeTree('/clickhouse/table/01/t_order','102')
partition by toYYYYMMDD(create_time)
primary key (id)
order by (id,sku_id);# hadoop103
create table t_order (id UInt32, sku_id String,total_amount Decimal(16,2), create_time  Datetime
) engine = ReplicatedMergeTree('/clickhouse/table/01/t_order','103')
partition by toYYYYMMDD(create_time)
primary key (id)
order by (id,sku_id);
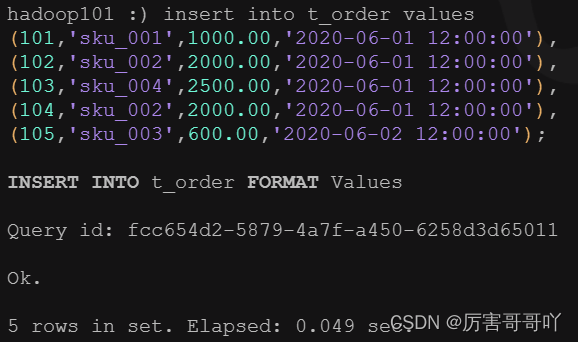
- 在hadoop101表t_order插入数据
insert into t_order values
(101,'sku_001',1000.00,'2020-06-01 12:00:00'),
(102,'sku_002',2000.00,'2020-06-01 12:00:00'),
(103,'sku_004',2500.00,'2020-06-01 12:00:00'),
(104,'sku_002',2000.00,'2020-06-01 12:00:00'),
(105,'sku_003',600.00,'2020-06-02 12:00:00');
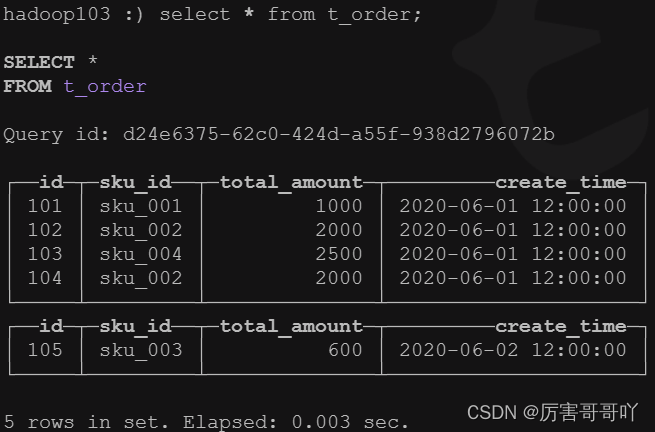
- 在hadoop101查询数据
- 在hadoop102查询数据
- 在hadoop103查询数据


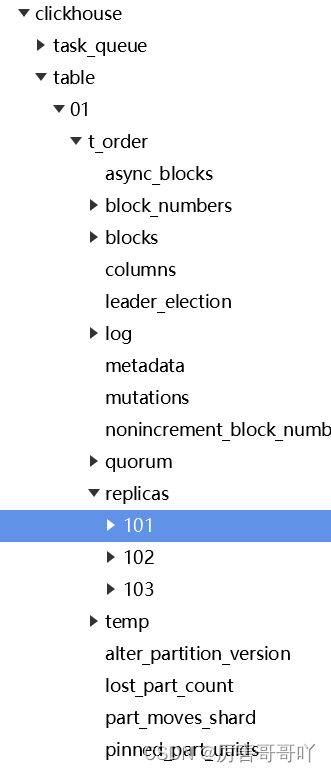
⑪查询zookeeper中的clickhouse存储数据是否成功
结语
至此,关于ClickHouse数据库的部署安装实现的内容到这里就结束了,我们下期见。。。。。。