

𝙉𝙞𝙘𝙚!!👏🏻‧✧̣̥̇‧✦👏🏻‧✧̣̥̇‧✦ 👏🏻‧✧̣̥̇:Solitary_walk
⸝⋆ ━━━┓
- 个性标签 - :来于“云”的“羽球人”。 Talk is cheap. Show me the code
┗━━━━━━━ ➴ ⷯ本人座右铭 : 欲达高峰,必忍其痛;欲戴王冠,必承其重。
👑💎💎👑💎💎👑
💎💎💎自💎💎💎
💎💎💎信💎💎💎
👑💎💎 💎💎👑 希望在看完我的此篇博客后可以对你有帮助哟👑👑💎💎💎👑👑 此外,希望各位大佬们在看完后,可以互相支持,蟹蟹!
👑👑👑💎👑👑👑
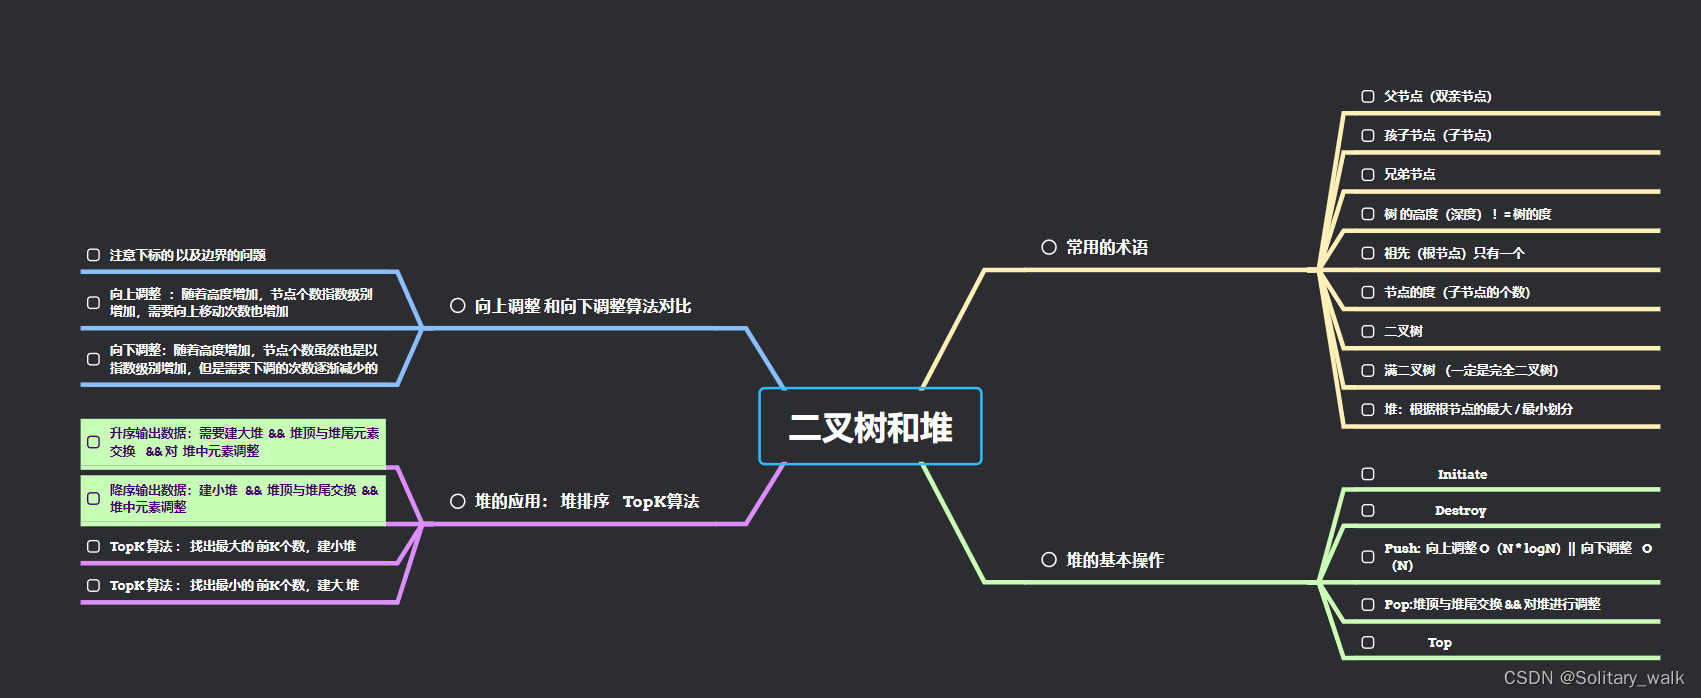
思维导图:
1:树的相关概念
1.1 在数据结构中数的重要性
首先:树在数据结构中扮演着重要的角色,它是一种非线性的数据结构,可以用来表示层次关系或者具有树状结构的数据。
其次:树的常见应用包括文件系统、组织结构、编译器中的抽象语法树等
再者:树有个好处,就是当节点有序的时候(即有序树),那么在这个树上搜索一个 节点 是很快的(log级别),所以,现在的索引一般都是用各种树( 数据库 如mysql大多用B+树)
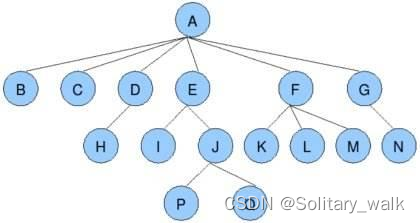
1.2 树的结构
1.3 树的概念
1.4 树的常见术语
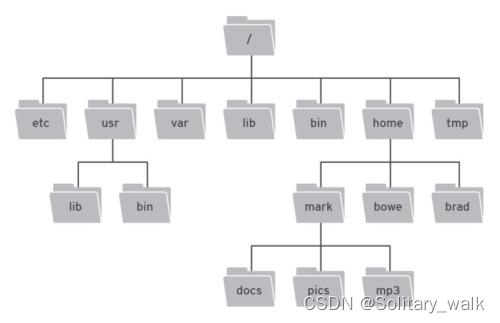
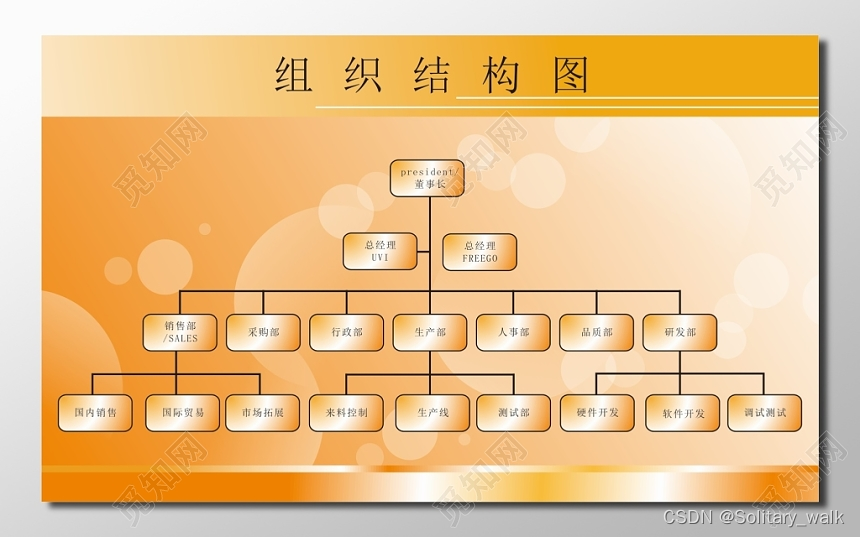
2:树的应用
文件的目录
组织结构:
3:堆的概念
3.1二叉树的概念
因为堆是与二叉树相关的,所以这里就不得不说一下二叉树
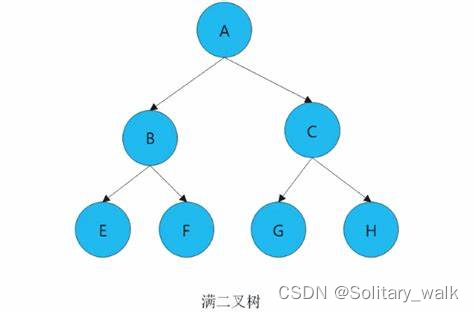
二叉树是一种树形数据结构,每个节点最多有两个子节点,分别称为左子节点和右子节点。二叉树有很多种不同的形式,比如满二叉树、完全二叉树、平衡二叉树等
注意:
二叉树不存在度 大于2的节点
二叉树的左子树 和右子树的次序是不能颠倒的(颠倒后是不同的树)
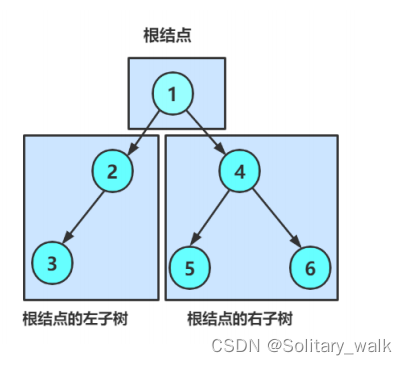
3.3 特殊的二叉树
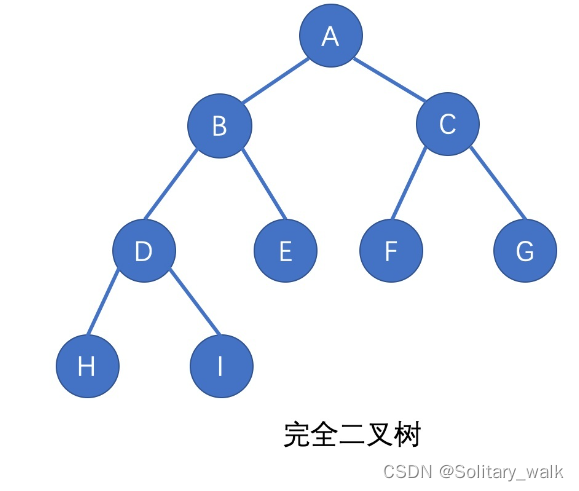
3.3 堆的概念
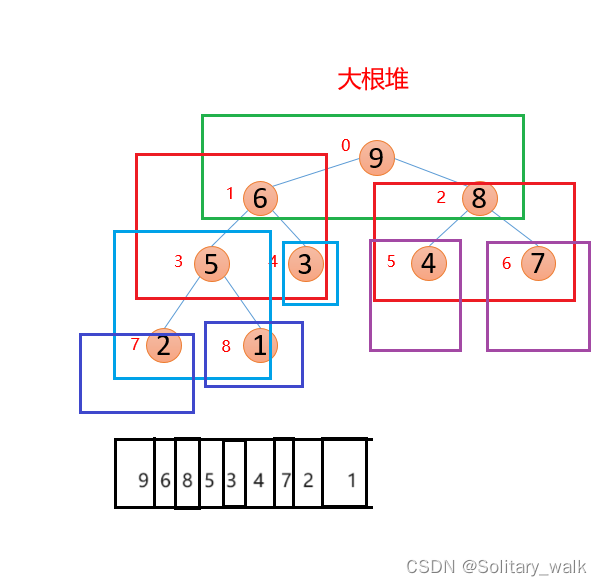
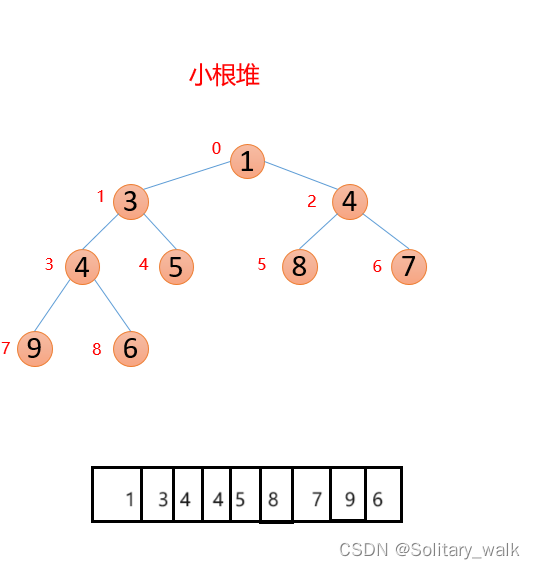
4:堆的结构
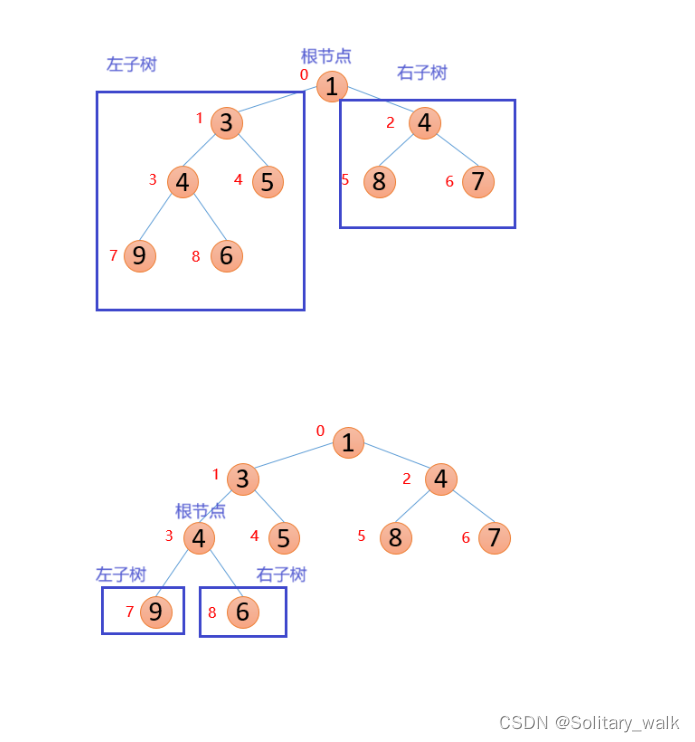
首先:无论是一个大堆还是个小堆:在结构上都是有根节点,左子树,右子树的
其次:堆要不是大堆,要不是小堆(有序的)
最后:堆的本质其实还是数组在物理结构上,在逻辑结构上是一个二叉树
typedef int HP_DataType;
typedef struct Heap
{HP_DataType* a;int size;//有效数据个数int capacity;//空间容量}HP;
5: 堆的创建
以建一个小堆为例来分析:
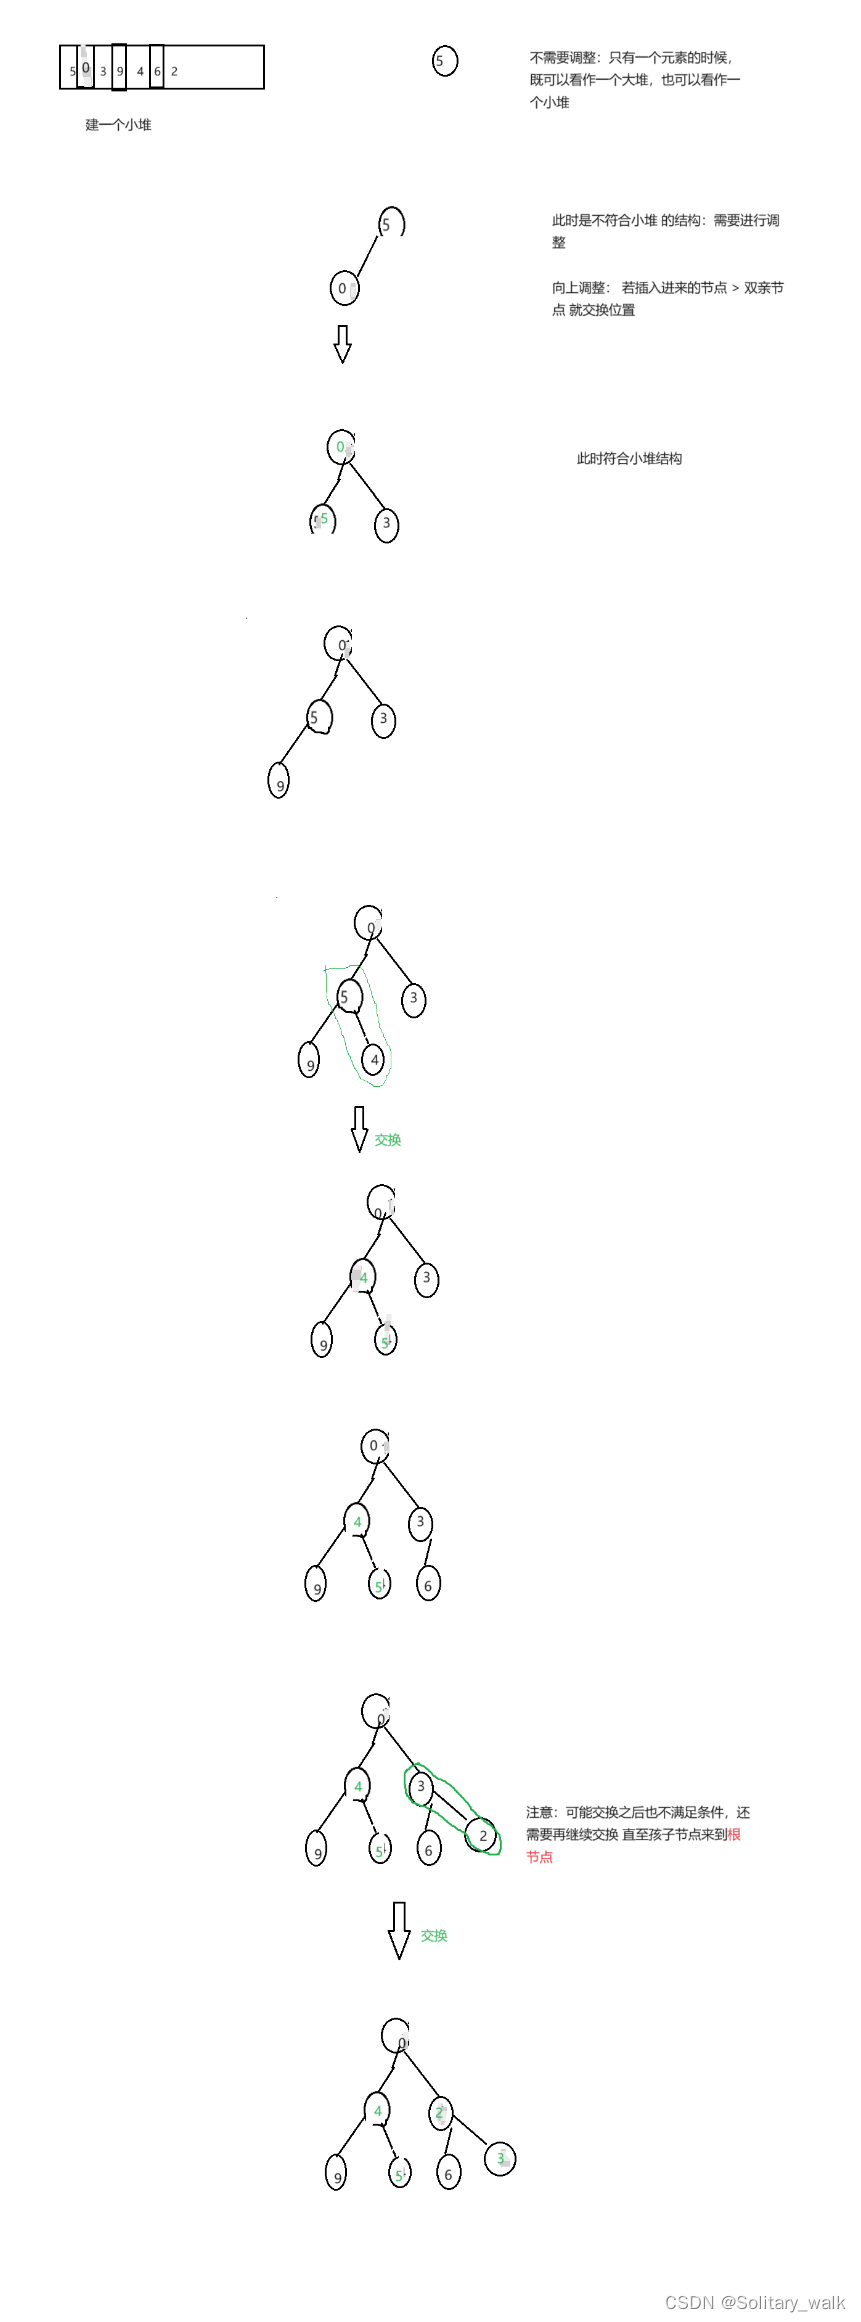
上调算法的思路分析:
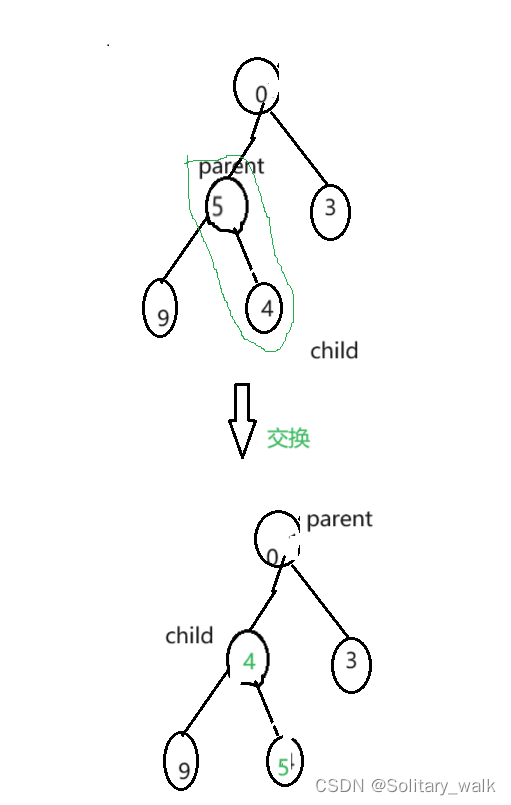
1)关键的如何确定每一次的双亲以及孩子节点的下标
二叉树的性质之一: 下标上 child = 2 * parent + 1
所以双亲的下标:parent = (child -1) / 2
2)因为每次进入数据最坏的情况下就是把孩子上调到根节点 此时就是最小堆了
所以结束条件的判断 child > 0
3)因为是建一个小堆:所以 若当前孩子节点 的值 > 双亲节点 的值就进行交换
并且交换完后 双亲 和 孩子继续迭代
child = parent ;
parent = (child -1) / 2 ;
交换
void Swap(HP_DataType* p1, HP_DataType* p2)
{assert(p1);assert(p2);HP_DataType tmp = *p1;*p1 = *p2;*p2 = tmp;
}
向上调整代码:
void Adujust_up(HP_DataType* a,int pos)
{assert(a);int child = pos;int parent = (child - 1) / 2;//下标从0开始while (child > 0){if (a[child] < a[parent]) //进行上调{/*int swap = php->a[child];php->a[child] = php->a[parent];php->a[parent] = swap;*/Swap(&(a[child]), &(a[parent]));//再继续下一轮child = parent;parent = (child - 1) / 2;}else//  同时也避免了 parent == child == 0 进入死循环{break;}}
}
数据进堆的代码:
void HP_push(HP* php, HP_DataType x)
{/*建小根堆1:空间是否有2:插入数据  同时 size++3:是否需要对插入的当前节点与双亲节点调整(递归的定义)*/assert(php);if (php->size == php->capacity){int newcapacity = php->capacity == 0 ? 4 : 2 * (php->capacity);//HP_DataType* tmp = (HP_DataType*)mealloc(php->a,sizeof(HP_DataType) * newcapacity);//扩容用reallocHP_DataType* tmp = (HP_DataType*)realloc(php->a,sizeof(HP_DataType) * newcapacity);//扩容用reallocif (tmp == NULL){perror("malloc fail");return ;}//扩容成功php->a = tmp;php->capacity = newcapacity;}php->a[php->size] = x;Adujust_up(php->a,php->size);//判断插入的节点是否需要向上调整//Adujust_up(&x,php->size);//判断插入的节点是否需要向上调整php->size++;}
5.2:堆的销毁
这个相比较之下就 so easy
void HP_Destroy(HP* php)
{assert(php);free(php->a);php->size = 0;php->capacity = 0;
}
5.3:堆的删除(删除堆顶元素)
思路分析:我们一般会这样思考:直接删除堆顶元素不就完了吗,但是删除之后的堆不在满足小堆的结构。若是重新建小堆的话,在时间上的开销是很大滴
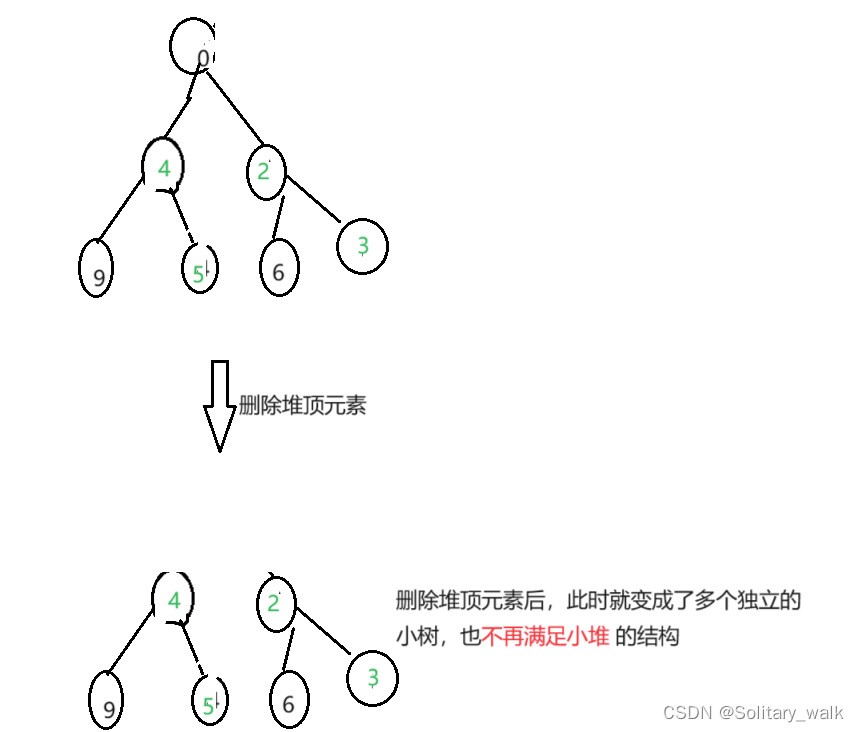
我们不妨格局打开,难道我就一定从堆顶这一个位置着手吗?
让堆顶元素与堆尾元素的值进行交换;此时堆的结构发生了改变但是相对于直接删除堆顶元素而言这并不是多多问题,此时我们在对改变的那个分支结构进行上调即可
草图见下:
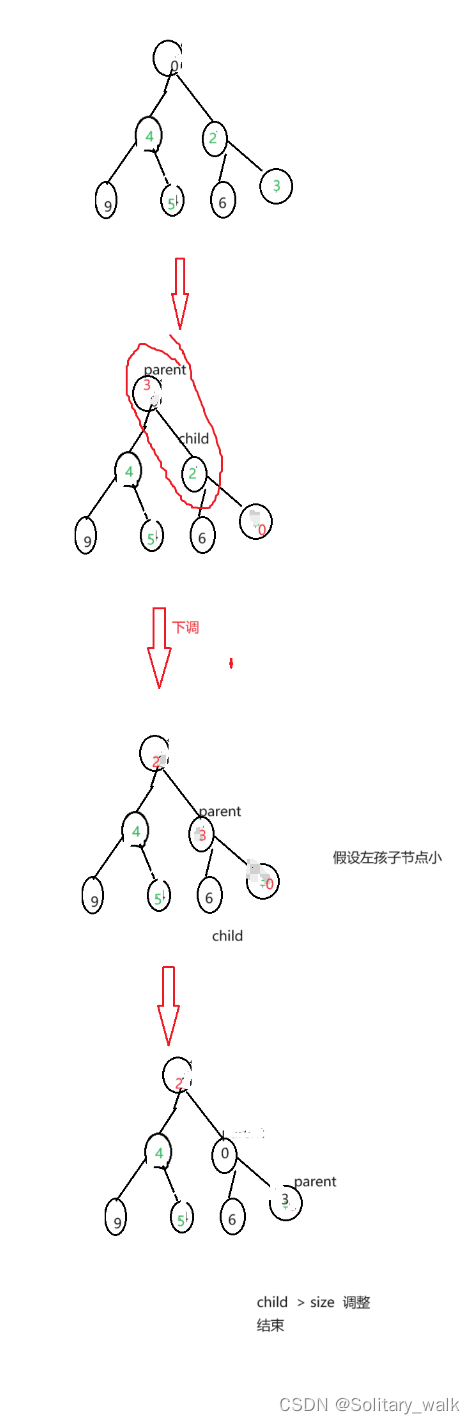
和向上调整思维一样:需要考虑双亲与孩子节点的下标
parent = 0;
child = 2 * parent + 1 ; //注意数组下标是从0 开始
让父亲节点来到孩子节点的位置 parent = child
此时孩子节点再继续下走 child = 2 * parent + 1 ;
注意:
1:采用假设思想 假设左孩子 节点在值最小
2:循环判断条件 孩子节点的下标 要 小于 数组的大小
3:找左右孩子最小节点的时候,若是右孩子节点值小,判断条件是 必须保证右孩子节的存在 child + 1 < num
向下调整代码:
void Adujust_Down(HP_DataType* a, int num,int parent_i)//必须保证左右子树是小根堆   第三个参数:双亲下标
{/*向下调整:保证此时还是一个小根堆  当 parent > child 进行交换关键是不知道左右孩子谁是最小节点*/assert(a);int parent = parent_i;int child = 2 * parent + 1;  //假设左孩子为最小的孩子节点while (child < num) //保证孩子在数组里面{if (child + 1 < num && a[child + 1] > a[child ]) //child + 1 < num 保证有孩子存在    a[child + 1] < a[child + 1] 右孩子可能是最小节点{child += 1;//更新最小孩子节点  }if (a[parent] < a[child]){Swap(&a[parent], &a[child]);//父 与 子 依次下移parent = child;child = 2 * parent + 1;}elsebreak;父 与 子 依次下移//parent = child;//child = 2 * parent + 1;//	以上2句代码在这err}
}
堆顶元素删除代码:
void HP_Pop(HP* php)
{/*把堆顶元素与堆尾元素的值进行交换;其次删除最后检查是否需要 进行向下调整注意对堆进行调整的时候必须保证 左右子树是有序堆*/assert(php);assert(!HP_Empty(php));Swap(&php->a[0], &php->a[php->size - 1]);php->size--;Adujust_Down(php->a, php->size,0);//必须保证是小根堆   }
5.4:堆的判空
bool HP_Empty(HP* php)
{assert(php);return php->size == 0;
}
5.5:堆顶元素获取
HP_DataType HP_Top(HP* php)
{assert(php);assert(!HP_Empty(php));return php->a[0];
}
5.6 完整代码
Heap.h
#pragma once
#include<stdio.h>
#include<stdlib.h>
#include<stdbool.h>
#include<assert.h>//堆的本质就是数组  注意:数组不一定是堆
/*
成为堆的条件
1:一定是完全二叉树 (包括满二叉树)
2:双亲节点的val > \ < 孩子节点的val(递归定义)
*/typedef int HP_DataType;
typedef struct Heap
{HP_DataType* a;int size;//有效数据个数int capacity;//空间容量}HP;void HP_Init(HP* php);
void HP_Destroy(HP* php);
void HP_push(HP* php,HP_DataType x);
void HP_Pop(HP* php);
bool HP_Empty(HP* php);
int HP_Size(HP* php);
HP_DataType HP_Top(HP* php);
void Swap(HP_DataType* p1, HP_DataType* p2);void Adujust_Down(HP_DataType* a, int num, int parent_i);//必须保证左右子树是小根堆   第三个参数:双亲下标
void Adujust_up(HP_DataType* a, int pos);
Heap.c
#define _CRT_SECURE_NO_WARNINGS 1
#include"Heap.h"void HP_Init(HP* php)
{assert(php);php->a = NULL;php->size= 0;php->capacity = 0;
}
void HP_Destroy(HP* php)
{assert(php);free(php->a);php->size = 0;php->capacity = 0;
}
void Swap(HP_DataType* p1, HP_DataType* p2)
{assert(p1);assert(p2);HP_DataType tmp = *p1;*p1 = *p2;*p2 = tmp;
}
void Adujust_up(HP_DataType* a,int pos)
{assert(a);int child = pos;int parent = (child - 1) / 2;//下标从0开始while (child > 0){if (a[child] < a[parent]) //进行上调{/*int swap = php->a[child];php->a[child] = php->a[parent];php->a[parent] = swap;*/Swap(&(a[child]), &(a[parent]));//再继续下一轮child = parent;parent = (child - 1) / 2;}else//  同时也避免了 parent == child == 0 进入死循环{break;}}
}void HP_push(HP* php, HP_DataType x)
{/*建小根堆1:空间是否有2:插入数据  同时 size++3:是否需要对插入的当前节点与双亲节点调整(递归的定义)*/assert(php);if (php->size == php->capacity){int newcapacity = php->capacity == 0 ? 4 : 2 * (php->capacity);//HP_DataType* tmp = (HP_DataType*)mealloc(php->a,sizeof(HP_DataType) * newcapacity);//扩容用reallocHP_DataType* tmp = (HP_DataType*)realloc(php->a,sizeof(HP_DataType) * newcapacity);//扩容用reallocif (tmp == NULL){perror("malloc fail");return ;}//扩容成功php->a = tmp;php->capacity = newcapacity;}php->a[php->size] = x;Adujust_up(php->a,php->size);//判断插入的节点是否需要向上调整//Adujust_up(&x,php->size);//判断插入的节点是否需要向上调整php->size++;}
void Adujust_Down(HP_DataType* a, int num,int parent_i)//必须保证左右子树是小根堆   第三个参数:双亲下标
{/*向下调整:保证此时还是一个小根堆  当 parent > child 进行交换关键是不知道左右孩子谁是最小节点*/assert(a);int parent = parent_i;int child = 2 * parent + 1;  //假设左孩子为最小的孩子节点while (child < num) //保证孩子在数组里面{if (child + 1 < num && a[child + 1] > a[child ]) //child + 1 < num 保证有孩子存在    a[child + 1] < a[child + 1] 右孩子可能是最小节点{child += 1;//更新最小孩子节点  }if (a[parent] < a[child]){Swap(&a[parent], &a[child]);//父 与 子 依次下移parent = child;child = 2 * parent + 1;}elsebreak;父 与 子 依次下移//parent = child;//child = 2 * parent + 1;//	以上2句代码在这err}
}void HP_Pop(HP* php)
{/*把堆顶元素与堆尾元素的值进行交换;其次删除最后检查是否需要 进行向下调整注意对堆进行调整的时候必须保证 左右子树是有序堆*/assert(php);assert(!HP_Empty(php));Swap(&php->a[0], &php->a[php->size - 1]);php->size--;Adujust_Down(php->a, php->size,0);//必须保证是小根堆   }
bool HP_Empty(HP* php)
{assert(php);return php->size == 0;
}
int HP_Size(HP* php)
{assert(php);return php->size;
}
HP_DataType HP_Top(HP* php)
{assert(php);assert(!HP_Empty(php));return php->a[0];
}
6:与堆相关算法的时间复杂度以及证明
6.1 下调算法来建堆
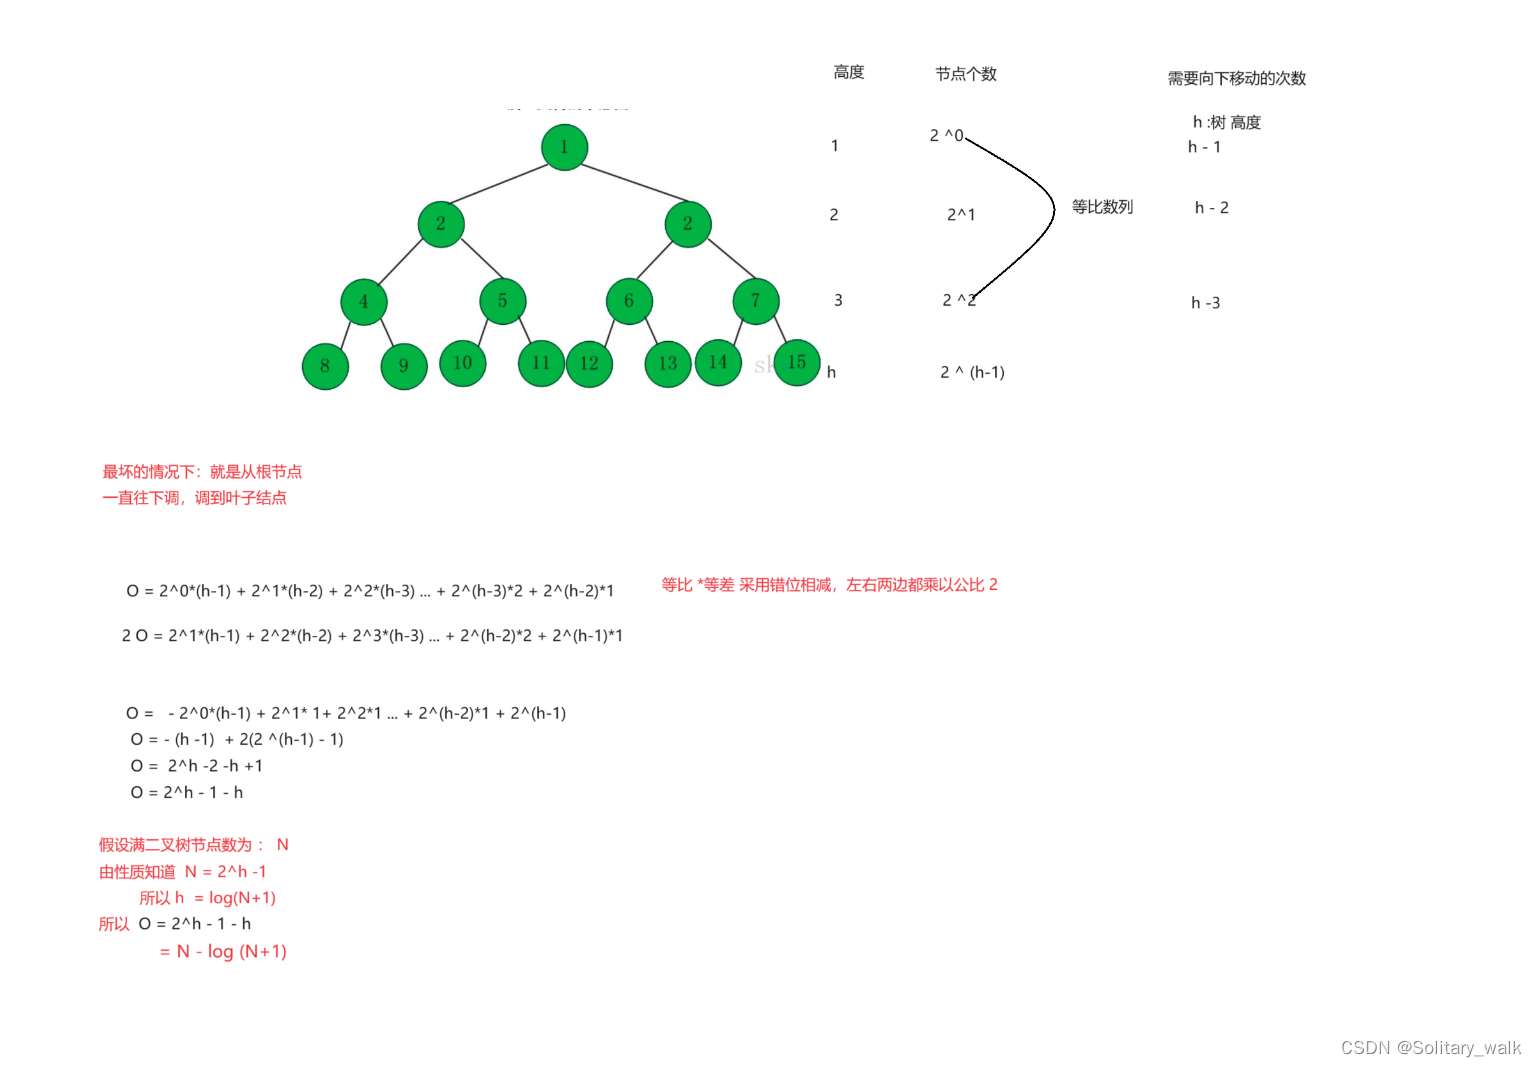
下调的时间复杂度 O(N)
证明如下:
下面就以最坏的情况来分析:满二叉树
6.2 上调算法来建堆
对应时间复杂度: N * (log N) 注意: N:节点个数
证明如下:
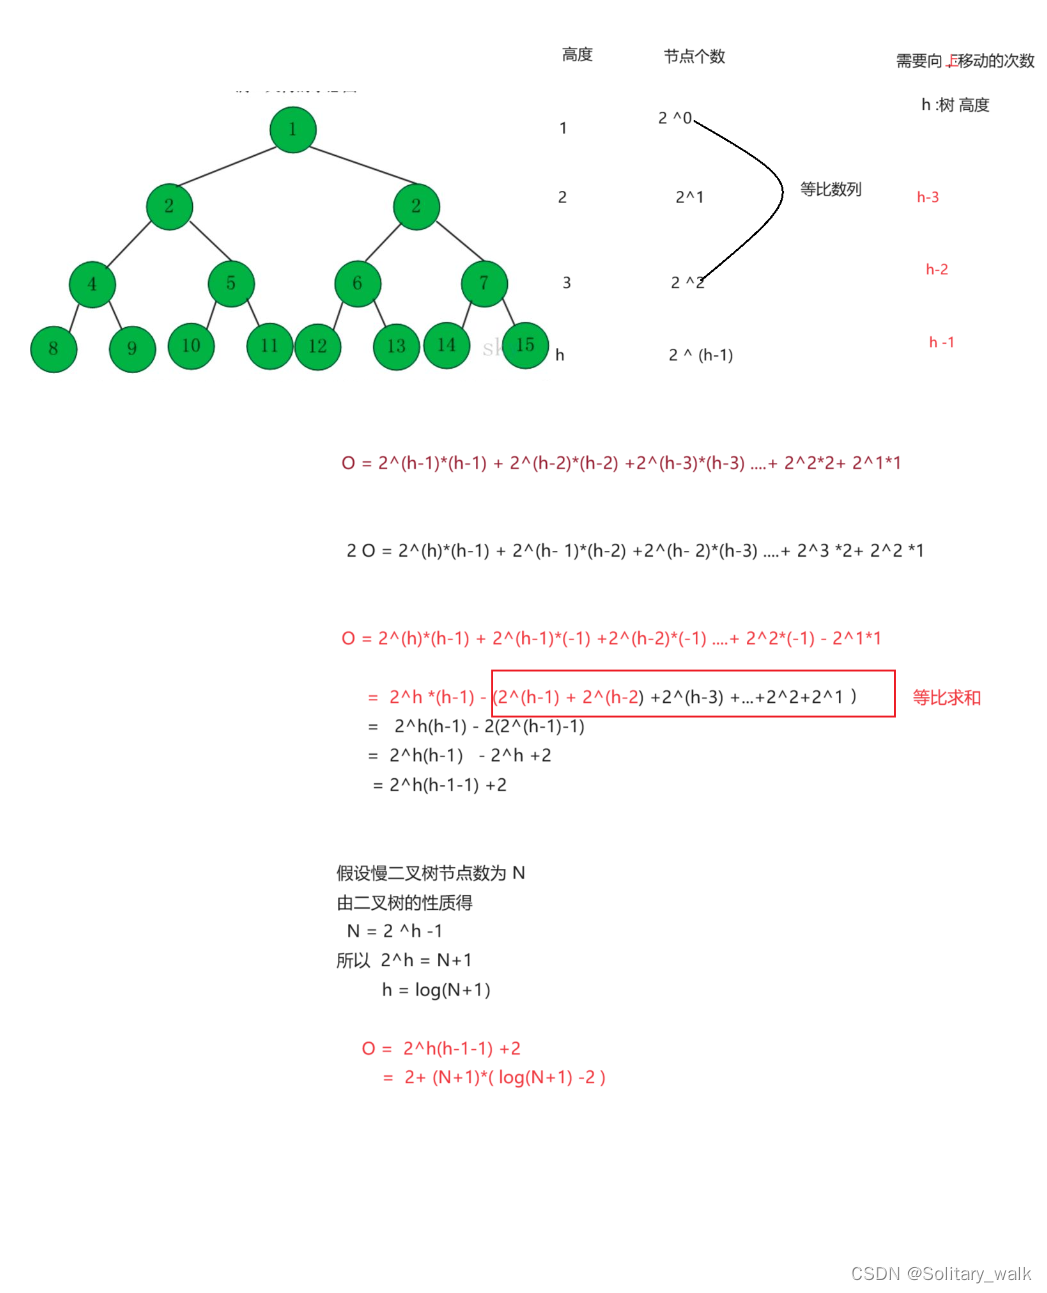
综合来看的话,虽然上调和下调的算法都可以完成建堆,但是在效率:下调 的算法更友好
7: 堆的应用
7.1堆排序
通过上面时间复杂度的解析想必堆在排序问题上自然也是占上风的。
7.1.1 把数据排成升序
若是想把一组数据排成升序我们到底是建大堆还是建小堆???

可能有些人会说,自然是建小堆了,这样每次从堆顶取出的元素永远都是当前堆中最小 的元素。确实是没有问题,但是每取出堆顶的元素后,堆中的数据不再是满足父与子之间的关系了,这就需要对堆来进行调整,也就是对余下的 N-1个元素重新建堆
我们可以建大堆:
1)首先把数组的数据进行调整,建成一个大堆,采用下调的方法
从第一个非叶子节点开始向下调整:孩子节点值 大于双亲节点值就进行调整;
直至调整到根节点为止
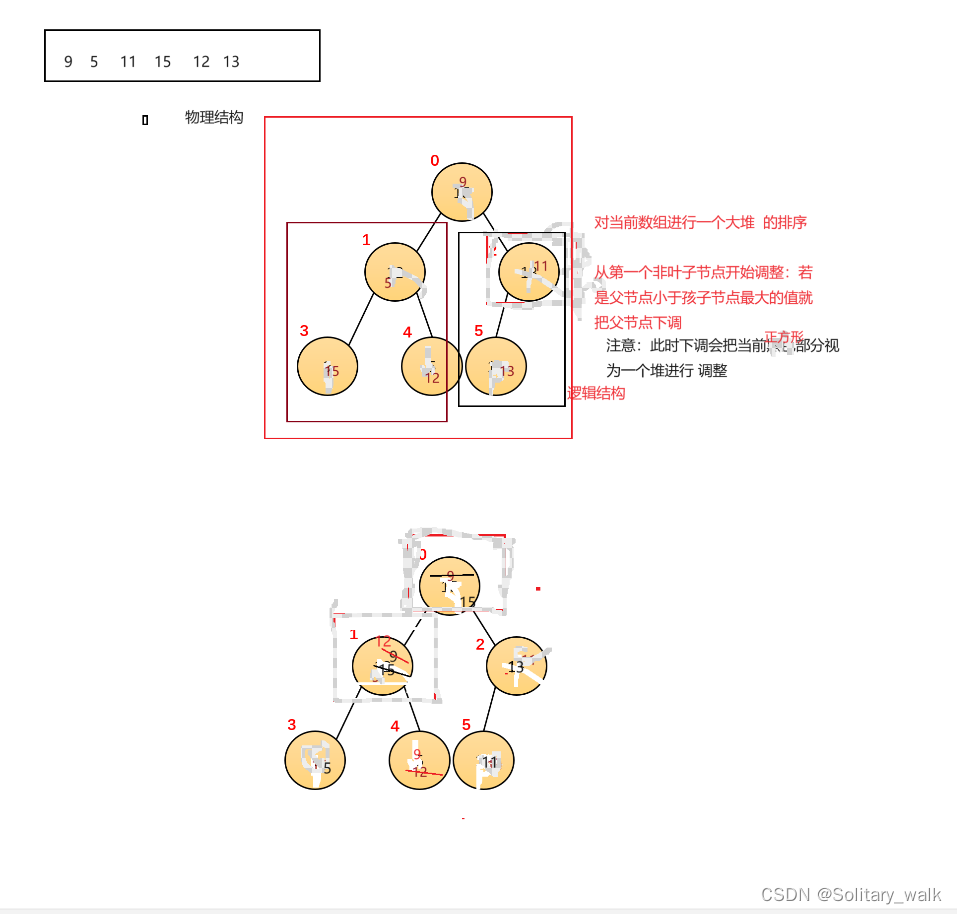
2)堆顶元素与堆尾元素进行交换,因为堆顶元素是当前堆中最大的了
3):再对余下的n-1个数进行调整找出最大,放在倒数 第二个位置
其实就是把每次堆顶元素进行头插,最终就变成升序数组
数组原来数据:a[ ] = {9,5,11,15,12,13}
运行结果:
升序排列的结果:
代码:
void Heap_Qsort(int* a, int num)
{/*构造一个升序的堆1:需要先建一个大堆2:堆顶与堆尾交换3:下调*/assert(a);int pos = 0;//把数组排成一个大堆for (pos = (num - 1 - 1) / 2; pos >= 0; pos--){Adujust_Down(a, num, pos);}// 堆顶与堆尾交换 &&  对非堆尾元素进行调整for (pos = num - 1; pos >= 0; pos--){Swap(&a[0], &a[pos]);// 依次选出堆顶最大的元素Adujust_Down(a, pos, 0);//此时pos 即表示 堆尾也表示 每次去掉堆尾元素的个数}}
7.1.2 把数据排成降序
相信有了前面升序排列的思维,再来这个降序排列应该是不在话下。
分析:
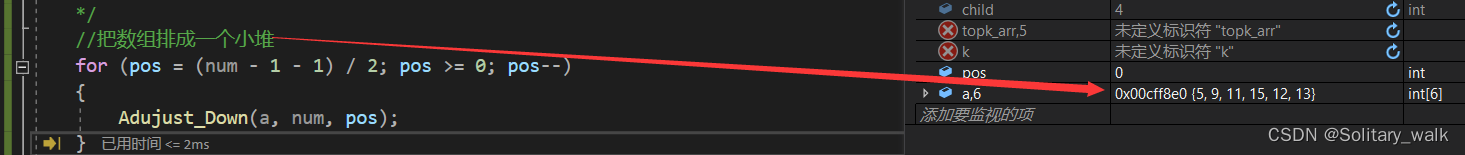
首先把数组整成一个小堆
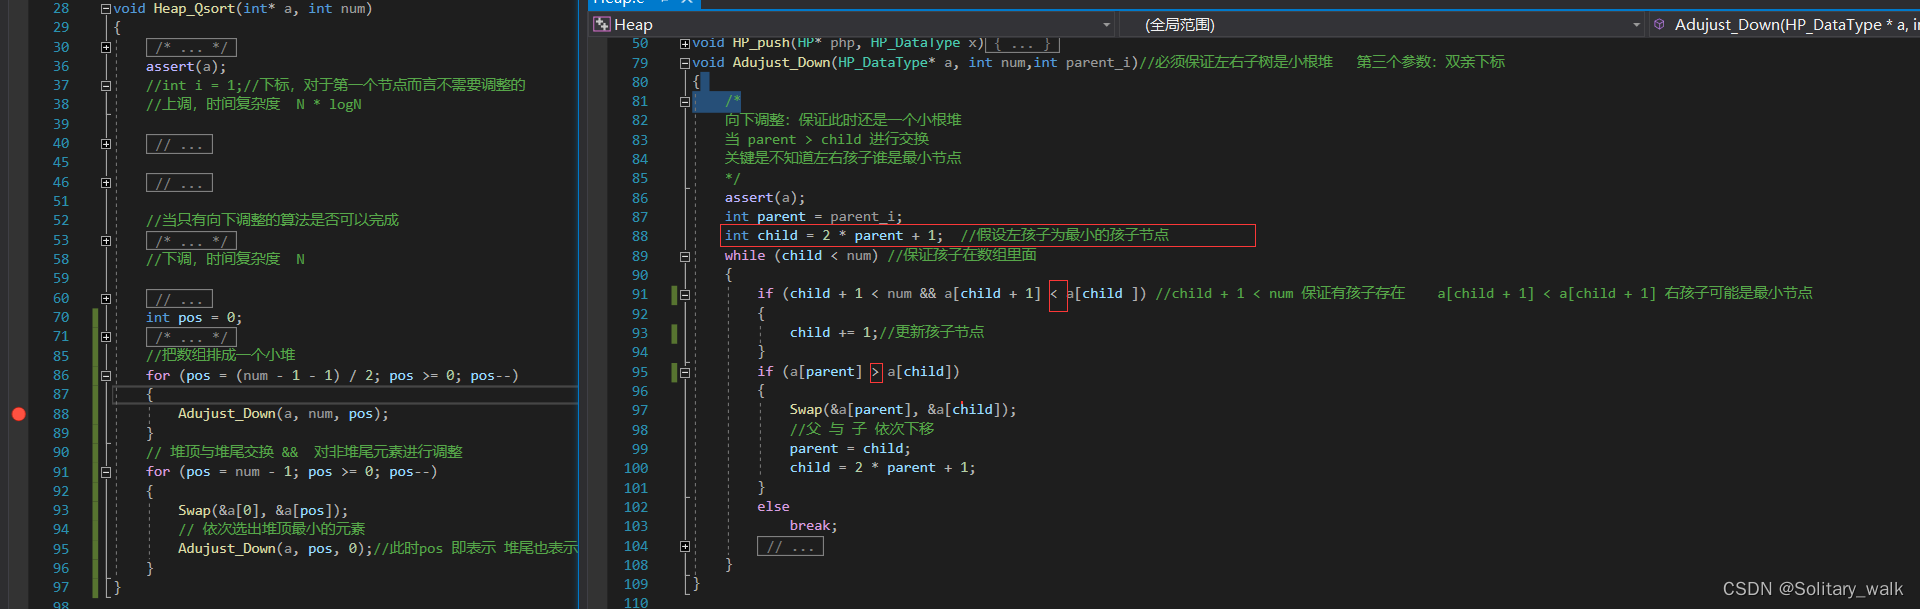
其次就是堆顶与堆尾元素进行交换;交换之后在对非堆尾的元素进行下调
排成小堆的结果:
降序的结果:

对应代码:可以复用上次升序的结果注意,有些地方需要改动
7.2经典的TopK问题
Top-K 问题是一类常见的算法问题,其中目的是从一组元素中找到排名前K的元素。具体来说,对于给定的一组数据。Top-K 问题要求找到其中最大(或最小)的K个元素。
生活中 的栗子:
当数据量非常大的时候(100万亿级别),我们就不能对这100万亿的数据全部进行排序了,
这是为什么呢?
因为内存的空间是非常有限的,这100万亿的数不会存储在内存上,而是在磁盘上,我们需要从文件里面进行读写 的操作。
所以说我们可以先对100万亿里面的前 K 个数据进行建堆,注意此时堆的大小就是固定的,就只存储K 个数据;
其次依次从余下的数据里面取出与堆顶元素进行比较,若满足指定的条件,则把当数据进行与堆顶元素 的交换
最后:交换之后再对堆中数据进行调整;之后就是重复以上操作,直至数组里面余下数据与堆顶元素比较完之后,堆中的K个数据就是所求
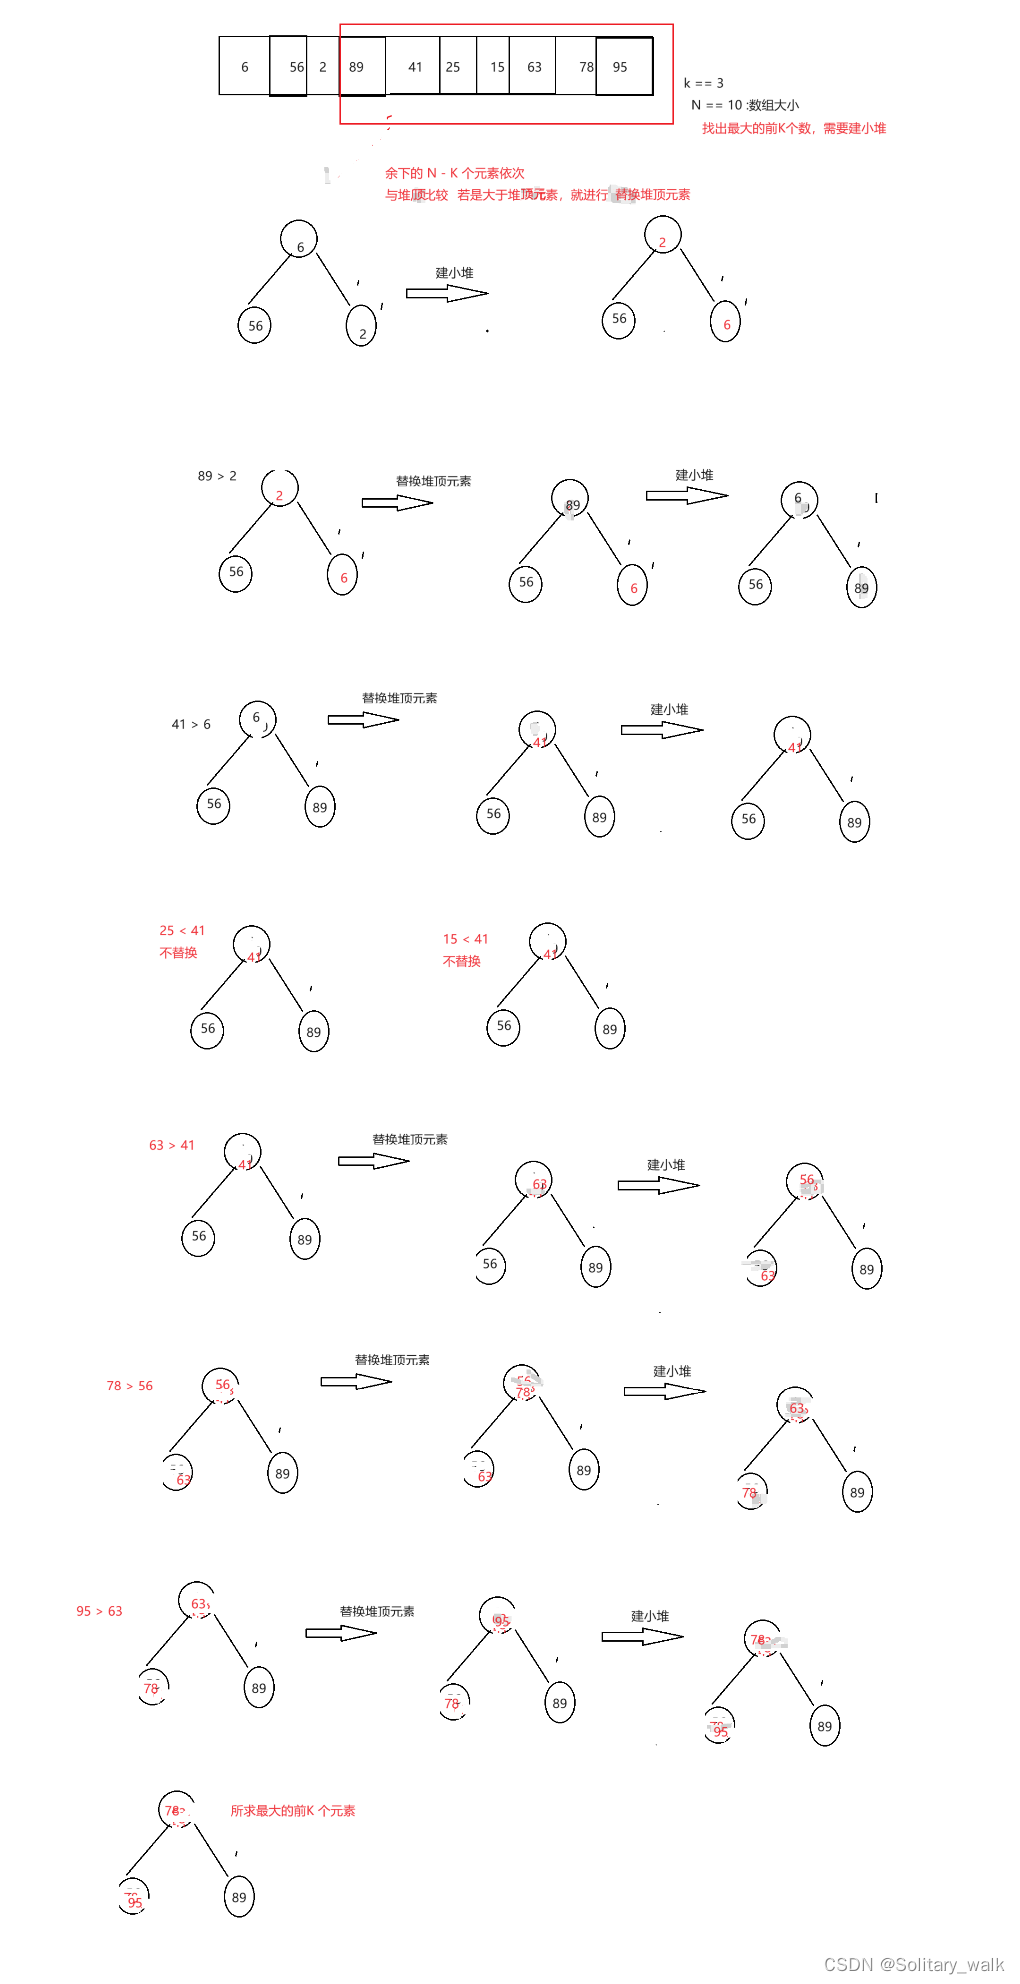
求最大的前三个数据:
首先对前3 数据进行建一个小堆,注意这里不能建大堆(若是建大堆的话,可能最大的数据在前三个数,其余2个数据在余下的 N-K个数里面,这样就不能搞了)
若是大于堆尾元素就替换掉当前的堆尾元素,并对当前堆中数据进行建小堆 的调整
草图见下:
代码:
void Print_TopK(int k ,int*a,int num_a)
{/*TopK 终极问题:当数据足够大的时候,面临空间的问题:直接减堆解决不了问题只能对前K个数先建堆 ==》在对后 n-k个数据依次进行与堆顶数据判断,是否取代当前堆顶元素 ==》 取代后需要重新调整*///找最大的K个数int* topk_arr = (int*)malloc(sizeof(int) * k);if (topk_arr == NULL){return;}// 前 K个数写到topK_arr这个数组里面int i = 0;for (i; i < k; i++){topk_arr[i] = a[i];}//对前K个数进行小堆的建立int pos = k;for (pos = (k - 1 - 1) / 2; pos >= 0; pos--){Adujust_Down(topk_arr, pos, 0);}//依次判断是否替换堆顶元素for (i = k; i < num_a; i++){if (a[i] > topk_arr[0]){Swap(&a[i], &topk_arr[0]);Adujust_Down(topk_arr, k, 0);}}//对最大的前K个数降序输出  for (i = k - 1; i >= 0; i--){Swap(&topk_arr[0], &topk_arr[i]);  //注意堆尾下标每次是不同的Adujust_Down(topk_arr, i, 0); }for ( i = 0; i < k; i++){printf("%d\n", topk_arr[i]);}}
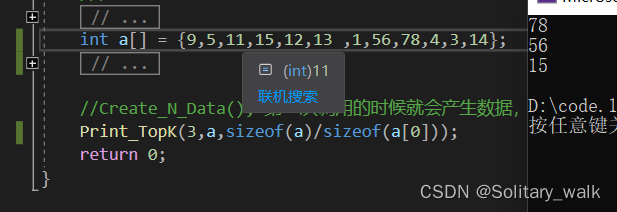
运行结果:
结语:
关于堆这一结构在我们日常生活中应用是非常广泛的,当然了对于这个TopK的问题,在面试中也是不可避免的!以上就是我share 的内容了,对于这块的知识体系着实不太好理解,难度相比之前的链表也不在一个层次,我们需要做到物理结构与逻辑结构的双向结合,当然了画图自然是必不可少(对于我这种小白而言,脑子转不过来)。希望此篇博客可以对你有些帮助,要是觉得不错的话,还希望各位大佬们多多支持(这篇博客也是倾注了不少尽力)。