

如果采用最原始的方法用Spring集成大模型,势必会引起大量繁杂众多的代码。我们可以利用Langchain4J提供的框架或者使用Spring Ai都可以集成。都能快速搭建我们的基于大模型的项目。
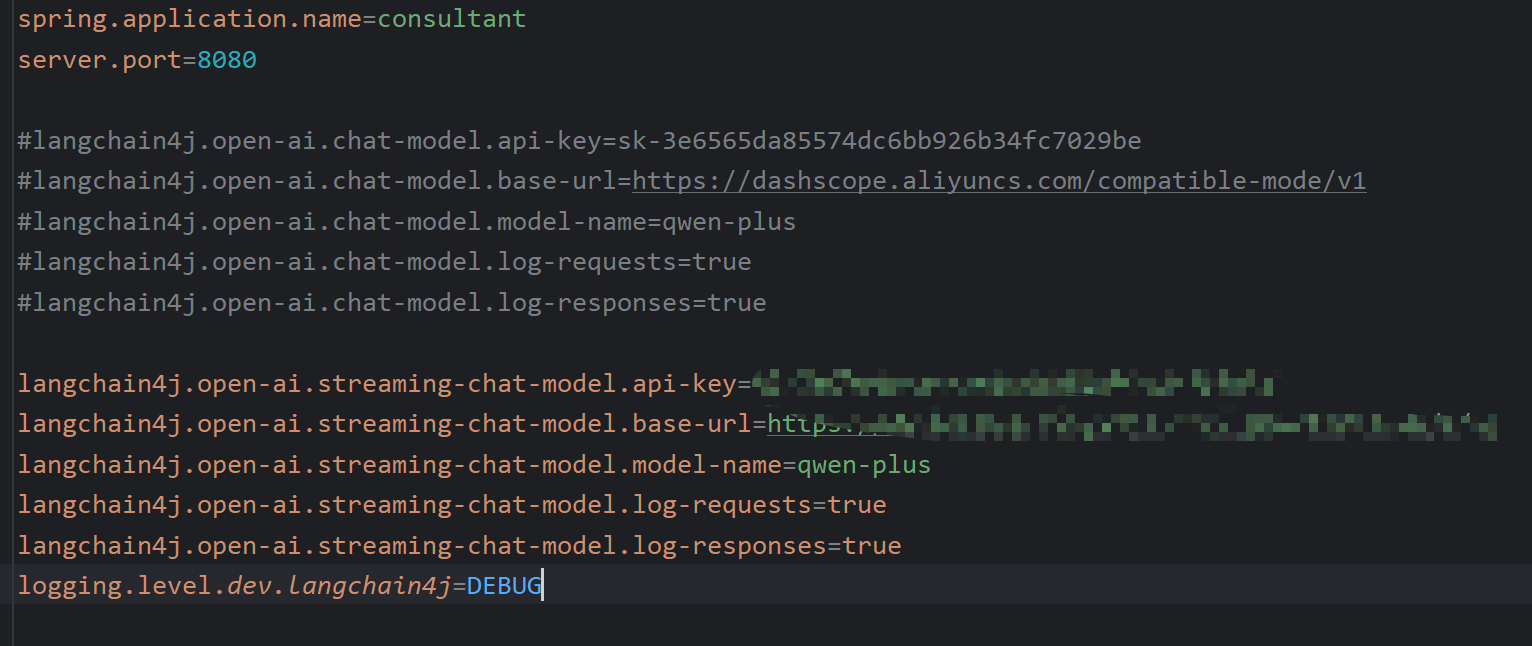
1. 基于流式输出的配置
2. 会话控制器

3. AIService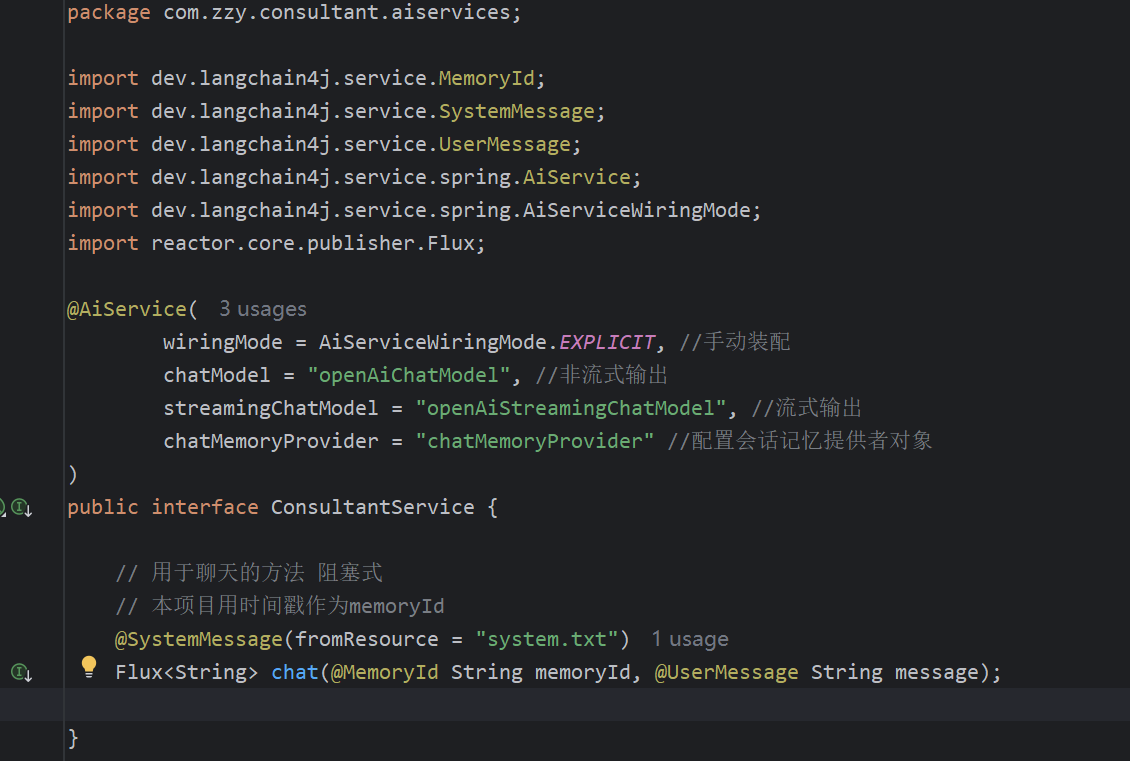
4. 会话记忆对象

5. 基于redis存储的ChatMemoryStore
@Repository
public class RedisChatMemoryStore implements ChatMemoryStore {@Autowiredprivate StringRedisTemplate redisTemplate;@Overridepublic List<ChatMessage> getMessages(Object memoryId) {System.err.println("开始获取消息");String json = redisTemplate.opsForValue().get(memoryId);//将json转换成listList<ChatMessage> list = ChatMessageDeserializer.messagesFromJson(json);System.out.println("记忆消息列表:"+list);return list;}@Overridepublic void updateMessages(Object memoryId, List<ChatMessage> list) {System.err.println("开始更新消息");//更新会话参数//将list转换成jsonString json = ChatMessageSerializer.messagesToJson(list);//将json数据存储到redis中 1天后删除redisTemplate.opsForValue().set(memoryId.toString(),json, Duration.ofDays(1));}@Overridepublic void deleteMessages(Object memoryId) {System.err.println("删除消息");redisTemplate.delete(memoryId.toString());}
}
6. Rag
1. 文档加载器

2. 文档解析器
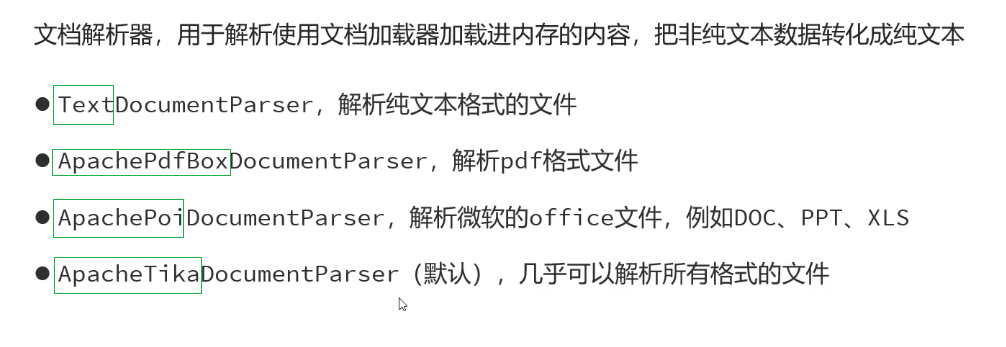
默认使用的是ApacheTika文档解析器,虽然几乎可以解析所有格式文件,但如果对于专业解析能力不强。
// 构建向量数据库@Beanpublic EmbeddingStore store(){//加载文档到内存中 指定文档解析器 默认不写为ApacheTikaDocumentParserList<Document> documents = ClassPathDocumentLoader.loadDocuments("content",new ApacheTikaDocumentParser());// 构建向量数据库InMemoryEmbeddingStore store = new InMemoryEmbeddingStore();//构建EmbeddingStoreIngestor 分词器 对文本进行切割 向量化 存储到向量数据库EmbeddingStoreIngestor ingestor = EmbeddingStoreIngestor.builder().embeddingStore(store).build();// 输入文本ingestor.ingest(documents);return store;}3. 文档分割器

无论是按照段落,行,句子,词... 最后在向量数据库还是要组成一个chunk进行向量化。
为了进一步保证chunk的稳定以及生成效果
我们一般使用递归分割器。大到小 --> 填满chunk
4. 向量模型
替换LangChain4J内嵌的向量模型,提升效果

5. 向量数据库RedisSearch
完整项目代码获取:私聊+点赞