

标题:VTD-CLIP:通过提示CLIP实现视频到文本的离散化
原文链接:https://arxiv.org/pdf/2503.18407
源码链接:https://github.com/isxinxin/VTD-CLIP (null)
摘要
视觉-语言模型搭建了视觉与语言理解的桥梁,并已被证明在视频识别任务中具有强大性能。现有方法主要依赖于对图像-文本预训练模型进行参数高效微调,但由于时序建模不足,这些方法往往存在可解释性有限和泛化能力较差的问题。为解决这些问题,我们提出了一种简单而有效的视频到文本离散化框架。由于多模态预训练中视觉和文本嵌入之间存在多对一的对比对齐,我们的方法重新利用冻结的文本编码器,从视频类别标签构建视觉码本。该码本通过特征查找将时序视觉数据有效转换为文本标记,并通过显式视频建模提供可解释的视频表示。此外,为增强对无关或噪声帧的鲁棒性,我们引入了置信度感知融合模块,通过码本评估关键帧的语义相关性,从而对其进行动态加权。再者,我们的方法融入可学习的文本提示以进行自适应码本更新。在HMDB-51、UCF101、SSv2和Kinetics-400上的大量实验验证了我们方法的优越性,相较于最先进的方法取得了更具竞争力的提升。代码将在https://github.com/isxinxin/VTD-CLIP公开。
1. 引言
大规模视觉-语言模型[3]在海量图像-文本对数据集上进行预训练,在对齐视觉和语言模态方面取得了重大进展[19],增强了机器理解能力,并实现了对视觉内容的类人描述生成[32, 82]。这些模型在多种任务中展现出广泛的适用性,包括图像 captioning[5, 46]、视觉问答[1, 9, 79]、图像-文本检索[14, 40, 44]和多模态生成[65, 75, 83]。鉴于这些成功,研究人员正越来越多地探索将此类模型应用于具有时序结构的视频数据[71, 76, 84]。
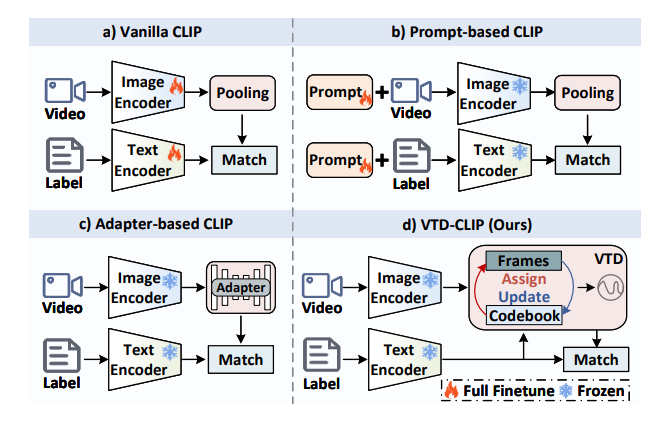
图1. 基于CLIP的方法对比。在基于CLIP的视频方法中,时序建模的有效性仍存在争议,因为对帧特征进行简单的平均池化就能达到更高的准确率。这表明,当视频语义由帧主导时,简单的时序聚合就足够了。我们的方法用基于码本的离散化替代时序建模,通过将视觉流分割为离散事件来识别动作,而非对帧进行平均。此外,我们的方法可以通过帧评分减轻错误和噪声帧的影响。
尽管图像-文本对齐取得了突破性成功,但将这一范式直接扩展到视频-文本对齐面临着关键挑战[26, 34, 41]。首先,训练有效的视频-文本对齐模型需要比图像-文本预训练多得多的配对训练数据,这种资源密集型需求不切实际。尽管参数高效微调方法降低了数据依赖性,但它们往往会因过拟合有限的任务特定数据而牺牲泛化能力,从而丢弃了从大规模预训练中继承的强大跨模态对齐能力[71, 76, 84]。这就引出了一个重要问题:如何在不牺牲其泛化优势的情况下,利用图像-文本对齐模型来理解视频?
一个理想的框架应该保留预训练视觉-语言模型的核心架构,同时利用其固有的泛化能力[24],保持从大规模多模态预训练中获得的零样本性能[56]。在实践中,这可以通过稀疏关键帧总结来实现,即通过选择代表性帧来编码视频的核心内容[78]。这种策略消除了大规模视频-文本对齐预训练的需求,同时支持高效的帧级特征提取[30, 53, 77]。此外,最近的研究表明,简单的时序聚合(如对帧级特征进行平均池化)在基准测试中就能取得有竞争力的性能[8, 22, 69]。这一发现也证明了视频语义的帧主导性质:在现实场景中,一小部分帧就足以代表整个视频的含义[28, 53],无需复杂的时序建模[13, 18]。因此,我们决心通过关键帧总结将图像-文本范式扩展到视频理解。
我们知道,视频语义类别与其主要内容相关,这促使我们利用预训练的文本类别作为视频总结和关键帧选择的原型[89, 90]。然而,由于视频的真实类别通常无法预先获得,我们需要一种伪标签机制来推断视频语义[72, 74]。为简单起见,可以通过CLIP的图像-文本对齐嵌入空间[19]对视频帧进行聚类,并将每个帧分配给语义最相似的文本类别。因此,通过将视频内容离散化为文本伪标签,我们引导关键帧选择偏向于具有高语义置信度的帧,同时抑制模糊或无关的帧[71]。图1对比了不同方法。我们的框架不仅通过计算密集的时序建模消除了时序依赖性,还保留了零样本泛化能力。
总之,我们引入了一种视频到文本离散化框架,称为VTD-CLIP,该框架通过将视觉内容离散化为具有语义意义的文本对齐标记来改进视频表示。具体而言,我们利用冻结的CLIP文本编码器作为视觉码本学习器,其中预定义的类特定文本嵌入作为码本元素。对于每个帧,我们提取视觉嵌入,并通过最大相似度将其量化为最近的文本码本元素,从而得到离散的帧级嵌入。然后,我们通过多数投票将帧级嵌入转换为离散的视频嵌入,优先考虑频繁出现或占主导地位的语义类别。接下来,我们计算每个帧的置信度分数。最后,我们使用置信度感知融合将离散视频嵌入与原始帧嵌入融合。我们框架的贡献可概括为以下三个方面:
• 我们提出了一种简单而有效的框架,通过将视觉内容离散化为文本对齐的语义嵌入来增强视频表示。
• 由于视觉-语言对齐,我们将文本编码器用作视觉码本学习器,并通过最近邻查找将每个帧量化为一个码本元素,通过帧投票得到离散特征。
• 我们在四个基准数据集上评估了所提出的方法,实验表明该方法相较于最先进的方法具有非常有竞争力的性能。
2. 相关工作
视觉-语言模型。自CLIP出现以来,视觉-语言模型取得了巨大进展[48,50,67]。鉴于其强大的零样本性能,最近的研究重点是高效微调CLIP以用于视频分析[52,62,66]。现有方法大致可分为两类[35,59],包括基于提示的方法和基于适配器的方法[73,88]。第一类中的典型方法包括ActionCLIP[63]、ViFi-CLIP[53]和VitaCLIP[68]。例如,Wang等人[63]提出了一种预训练、提示和微调范式。Rasheed等人[53]对CLIP编码器进行了全微调。Wasim等人[68]向CLIP编码器引入了多个提示标记。对于第二类,代表性方法包括XCLIP[47]、VideoPrompt[26]和EVL[38]。Ni等人[47]采用了跨帧通信和多帧整合。Ju等人[26]和Lin等人[38]通过轻量级Transformer编码时序信息。Wu等人[70]采用预训练语言模型来创建语义目标。Qing等人[49]分离了空间和时间信息。Lin等人[37]提出了一种结合GPT-3的无监督方法[7]。Kahatapitiya等人[27]优先考虑文本增强而非视觉知识。Chen等人[11]增强了文本知识以提高视频的泛化能力。
离散表示学习。离散分词器在视觉-语言模型中至关重要,通过将多模态数据桥接到统一表示中,增强了零样本泛化能力[39]。例如,Van等人[61]开创了用于离散潜在空间学习的神经向量量化方法。Razavi等人[54]通过多级分层VQ-VAE扩展了这一方法。Vahdat等人[60]使用重要性加权下界进行训练,不同于传统的证据下界。Esser等人[17]结合了CNN的归纳偏置和Transformer的表达能力。Ramesh等人[51]通过自回归联合标记建模进行跨模态对齐。Bao等人[6]通过掩码图像建模预测离散视觉标记。离散方法面临码本坍缩问题,即扩展码本时元素多样性会逐渐减少。虽然Mentzer等人[45]采用了一种边界函数将每个特征通道四舍五入为整数,但我们提出了一种替代方法,利用文本编码器作为码本学习器,并通过文本提示更新码本。
3. 提出的方法
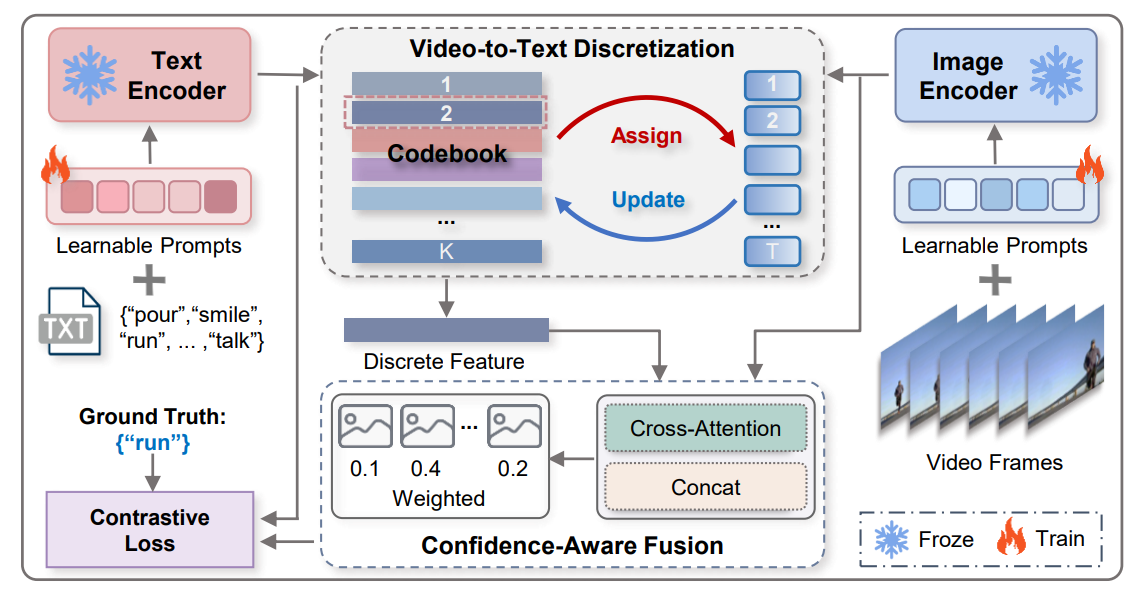
图2. VTD-CLIP的架构。我们首先使用预训练的CLIP编码器提取帧嵌入和文本嵌入,并利用文本嵌入构建视觉码本。然后,通过视频到文本离散化对视觉嵌入进行离散化,得到离散特征。最后,通过置信度融合生成视频特征。
如图2所示,我们的框架通过三个模块扩展了CLIP的泛化能力:1)通过冻结图像编码器ϕv(;θv)\phi_{v}(; \theta_{v})ϕv(;θv)和文本编码器ϕt(⋅;θt)\phi_{t}(\cdot ; \theta_{t})ϕt(⋅;θt)对帧特征xxx和文本特征ccc进行跨模态特征提取;2)用于视频离散特征vvv的视频到文本离散化;3)用于视频特征v^\hat{v}v^的置信度感知融合。
3.1 特征提取
给定输入视频V={It}V=\{I_{t}\}V={It},其中It∈Rh×w×3I_{t} \in \mathbb{R}^{h \times w \times 3}It∈Rh×w×3,我们的方法首先将VVV划分为TTT个均匀的时间片段,并在每个片段中随机采样一帧。然后将这些帧输入到ϕv(;θv)\phi_{v}(; \theta_{v})ϕv(;θv)中,该编码器将每个帧分解为hp×wp\frac{h}{p} \times \frac{w}{p}ph×pw个不重叠的p×pp \times pp×p块。遵循先前的方法[25,85],我们还向块序列中注入可学习的视觉提示,以缓解帧-文本模态的语义差距:
st=[u1][u2]⋯[um][et],t∈[1,T],(1)s_{t}=\left[u_{1}\right]\left[u_{2}\right] \cdots\left[u_{m}\right]\left[e_{t}\right], t \in[1, T], (1)st=[u1][u2]⋯[um][et],t∈[1,T],(1)
其中sts_{t}st是第ttt帧的输入,ete_{t}et是其所有块,umu_{m}um是可训练的提示标记,m=16m=16m=16。我们通过以下公式得到第ttt帧的特征xt∈Rdx_{t} \in \mathbb{R}^{d}xt∈Rd:
xt=ϕv(st;θv).(2)x_{t}=\phi_{v}\left(s_{t} ; \theta_{v}\right) . (2)xt=ϕv(st;θv).(2)
3.2 视频到文本离散化
利用大规模对比预训练中的视觉-语言对齐,我们重新利用文本编码器作为视觉码本学习器,其中文本类别嵌入构成视频理解的原型。
文本语义原型。我们使用冻结的文本编码器ϕt(⋅;θt)\phi_{t}(\cdot ; \theta_{t})ϕt(⋅;θt)提取文本类别嵌入:
ck=ϕt(yk;θt),(3)c_{k}=\phi_{t}\left(y_{k} ; \theta_{t}\right), (3)ck=ϕt(yk;θt),(3)
yky_{k}yk表示与第kkk个文本嵌入ck∈Rdc_{k} \in \mathbb{R}^{d}ck∈Rd对应的第kkk个类标签,这些类别嵌入被视为视频中主要内容提取的视觉原型。然后,我们通过收集这些原型来初始化视觉码本C={c1,c2,…,cK}∈Rd×KC=\{c_{1}, c_{2}, \ldots, c_{K}\} \in \mathbb{R}^{d \times K}C={c1,c2,…,cK}∈Rd×K,其中KKK表示类别数量。视频帧通过将其视觉特征xix_{i}xi映射到最近的码本元素进行量化,如下所示:
xiq=Q(xi):=argminck∈C∥xi−ck∥,(4)x_{i}^{q}=Q\left(x_{i}\right):=\underset{c_{k} \in \mathcal{C}}{\arg \min }\left\|x_{i}-c_{k}\right\| , (4)xiq=Q(xi):=ck∈Cargmin∥xi−ck∥,(4)
其中xiqx_{i}^{q}xiq是离散特征。虽然式(4)类似于VQ-VAE[61]的向量量化公式,但我们的方法在三个方面有所不同:
-码本稳定性与坍缩。从零开始训练的VQ-VAE的码本仍然容易坍缩为一个主导元素[16]。但是,我们的文本衍生码本ccc通过冻结的文本编码器获得,并保留语义结构。
-固定超参数。VQ-VAE需要手动调整对数据集复杂性敏感的码本大小KKK,而我们的方法将KKK扩展到与语义类别数量匹配。
-虽然VQ-VAE码本在训练后保持静态,但我们的方法支持通过文本提示动态更新码本。我们将详细说明它们的差异。因此,我们的码本可以提供一个固定且视觉对齐的替代方案。由于提示学习[80],我们可以通过使用文本提示动态更新码本。
借助提示更新码本。文本编码器接收一组结构化的模板标记,例如“a photo of a {class}”,其中{class}标记表示数据集中的类别标签。这些标记通过冻结的文本编码器ϕt(⋅;θt)\phi_t(\cdot; \theta_t)ϕt(⋅;θt)被投影到语义嵌入空间中。遵循CoOp框架[87],我们构建了一个自适应码本,该码本能动态对齐视觉内容与原型,同时保持跨模态一致性:
yk=[w1][w2]⋯[wn][classk],k∈[1,K].(5)y_k = [w_1][w_2] \cdots [w_n][class_k],\ k \in [1, K].\ (5)yk=[w1][w2]⋯[wn][classk], k∈[1,K]. (5)
我们将K∈N+K \in \mathbb{N}^+K∈N+定义为类别数量。wiw_iwi表示第iii个可学习文本提示,其维度与冻结文本编码器的输入标记维度相匹配。每个提示由16个可学习标记参数化,这些标记通过标准高斯分布初始化。尽管文本编码器会输出标记级嵌入和全局CLS嵌入,但我们仅将后者用作跨模态对齐的文本表示,从而得到视觉-语义码本CCC,其中每个元素对应于特定类别提示的CLS嵌入。
基于最近邻的硬分配。我们的方法采用硬分配而非软加权来生成帧级伪标签。一方面,每个帧特征被映射到文本空间中最近的类别原型。这消除了视觉相似类别(例如“running”与“fast walking”)之间的混淆性解释,强化了类别决策边界,减少了标签模糊性。另一方面,与目标文本原型具有高相似性的帧被保留为重要内容,而像背景或无关内容等低相似性片段则被自动排除。这种跨模态硬分配无需显式的时序建模即可自适应地聚焦于关键帧,有效抑制了冗余信息。
具体而言,给定帧特征xtx_txt和码本CCC,我们计算跨模态亲和矩阵stk=cos(xt,ck)s_{tk} = \cos(x_t, c_k)stk=cos(xt,ck),其中cos(⋅)\cos(\cdot)cos(⋅)表示嵌入空间中的余弦相似度,stks_{tk}stk是矩阵S∈RT×KS \in \mathbb{R}^{T \times K}S∈RT×K的元素。为实现粗粒度的帧到文本对齐,我们按照式(4)搜索码本CCC中具有最大亲和度的元素,并将第ttt帧分配给文本原型ck^tc_{\hat{k}_t}ck^t:
k^t=argmaxk∈{1,2,…,K}stk.(6)\hat{k}_t = \arg\max_{k \in \{1,2,\ldots,K\}} s_{tk}.\ (6)k^t=argk∈{1,2,…,K}maxstk. (6)
这种硬分配通过仅保留每个帧的主导语义对应关系来生成稀疏性。由此产生的稀疏性抑制了噪声或模糊的语义映射,同时保持了可解释的选择。
原型袋视频类别。我们通过稀疏相关聚合计算语义原型激活。给定二进制掩码M∈{0,1}T×KM \in \{0,1\}^{T \times K}M∈{0,1}T×K,其中mtk^t=1m_{t\hat{k}_t} = 1mtk^t=1表示第ttt帧通过式(6)中的硬分配被分配给第k^t\hat{k}_tk^t个文本原型。视频原型的选择如下:
kmax=argmaxk∈{1,2,…,K}mk⊙sk.(7)k_{\max} = \arg\max_{k \in \{1,2,\ldots,K\}} m_k \odot s_k.\ (7)kmax=argk∈{1,2,…,K}maxmk⊙sk. (7)
其中mkm_kmk和sks_ksk分别表示MMM和SSS的第kkk列向量,⊙\odot⊙表示哈达玛积,kmaxk_{\max}kmax为最活跃文本原型的索引。MMM强制每个帧进行独热但不可微分的原型选择,而SSS则通过视觉-文本对齐强度对原型进行加权。
最终的视频表示vvv继承最活跃原型的语义嵌入,即v=ckmaxv = c_{k_{\max}}v=ckmax。
3.3 置信度感知融合
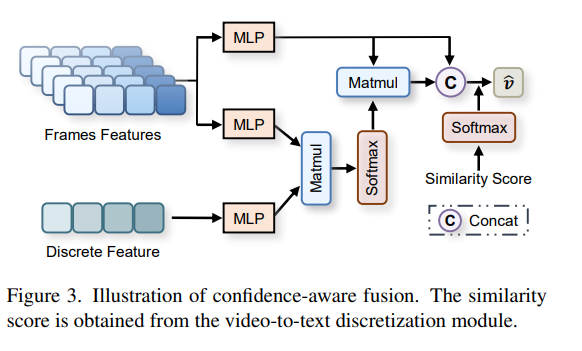
传统方法采用简单的时序池化(如平均池化)来融合帧特征[31,81]。然而,此类方法通常受到无关帧的时序冗余和低质量帧的噪声传播的影响。最近的工作引入了帧过滤技术来增强序列的连贯性和视觉吸引力[43]。不同的是,我们的方法提出了如图(3)所示的置信度感知融合,基于文本对齐的相似度对帧进行动态加权。
具体而言,给定来自视频到文本离散化的vvv,我们将离散视频特征融合为:
f=Cross Attn(v,x)+x,(8)f=\text{Cross Attn}(v, x)+x, (8)f=Cross Attn(v,x)+x,(8)
其中交叉注意力层将vvv与xxx整合,而跳跃连接保留时空细节。
对于每个视频帧,我们首先从视频到文本离散化模块获得与相应文本原型的帧级相关性stkmaxs_{t k_{\max }}stkmax,其中kmaxk_{\max }kmax来自式(7)。然后,我们通过温度缩放的softmax对置信度分数进行归一化,并通过聚合置信度加权特征获得最终视频嵌入:
v^=∑t=1Texp(stkmax/τ)∑t=1Texp(stkmax/τ)×f.(9)\hat{v}=\sum_{t=1}^{T} \frac{\exp \left(s_{t k_{\max }} / \tau\right)}{\sum_{t=1}^{T} \exp \left(s_{t k_{\max }} / \tau\right)} \times f . (9)v^=t=1∑T∑t=1Texp(stkmax/τ)exp(stkmax/τ)×f.(9)
我们通过交叉熵损失最大化批次中视频表示与真实文本嵌入之间的跨模态对齐,得到目标函数:
L=−∑ilogexp(cos(v^i,ci)/τ)∑jexp(cos(v^i,cj)/τ).(10)\mathcal{L}=-\sum_{i} \log \frac{\exp \left(\cos \left(\hat{v}_{i}, c_{i}\right) / \tau\right)}{\sum_{j} \exp \left(\cos \left(\hat{v}_{i}, c_{j}\right) / \tau\right)} . (10)L=−i∑log∑jexp(cos(v^i,cj)/τ)exp(cos(v^i,ci)/τ).(10)
4. 实验
4.1 实验设置
数据集。我们在四个数据集上进行了实验,包括HMDB-51[29]、UCF-101[57]、Something Something-v2(SSv2)[20]和Kinetics-400(K-400)[10]。HMDB-51包含来自51个动作类别的6849个视频片段,每个类别至少有101个视频片段。
• UCF-101提供了101个动作类别的13320个视频序列,每个类别至少有100个视频。
SSv2包括来自174个动作类别的220847个视频序列,其中训练集包含168913个,验证集24777个,测试集27157个,特别围绕对象交互和使用场景。
• K-400包含400个动作类别,约有306245个视频片段。该数据集分为训练集240000个、验证集20000个和测试集40000个。
实现细节。我们的方法采用冻结的CLIP,其文本和视觉编码器使用ViT-B/16骨干网络。我们通过在HMDB-51、UCF101、SSv2和K-400上的零样本实验,以及在HMDB-51、UCF-101和SSv2上的少样本实验,评估了我们方法的泛化能力。我们使用8×NVIDIA A100 GPU,每个GPU的批量大小为8。我们使用Adam优化器,权重衰减为0.001,K-400的学习率为0.004,其他数据集的学习率为0.0004。
4.2 主要结果
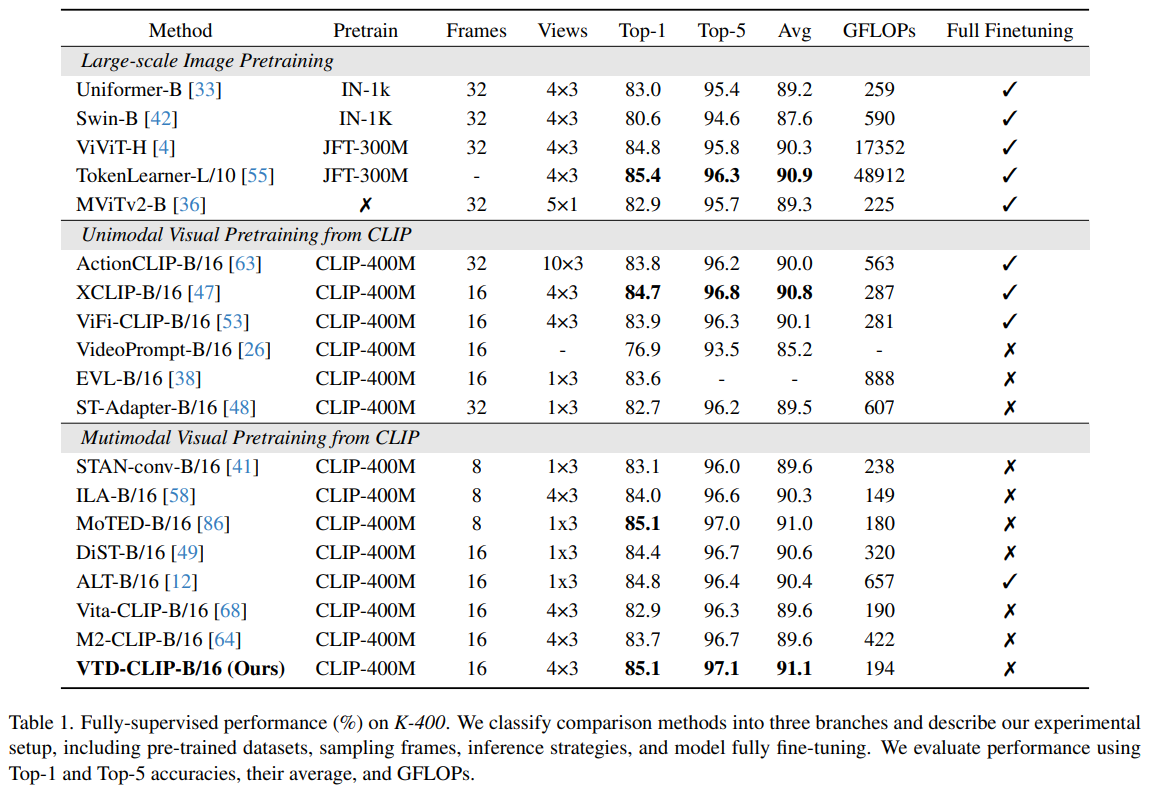
全监督视频识别。我们在K-400上进行全监督实验,以验证所提方法的有效性。如表1所示,我们的方法与大多数基于CLIP的方法相比表现出竞争力,除了采用大型ViT骨干网络和全微调的TokenLearner-L/10。VTD-CLIP的计算量为194 GFLOPs,明显轻于XCLIP-B/16(287 GFLOPs)和ActionCLIP-B/16(563 GFLOPs)。虽然MoTED-B/16通过使用更少的帧取得了较好的结果,但我们的方法在不增加过多计算量的情况下减轻了冗余。通过将特征映射到文本对齐空间,VTD-CLIP为模型大小和训练成本至关重要的场景提供了一种轻量级替代方案。
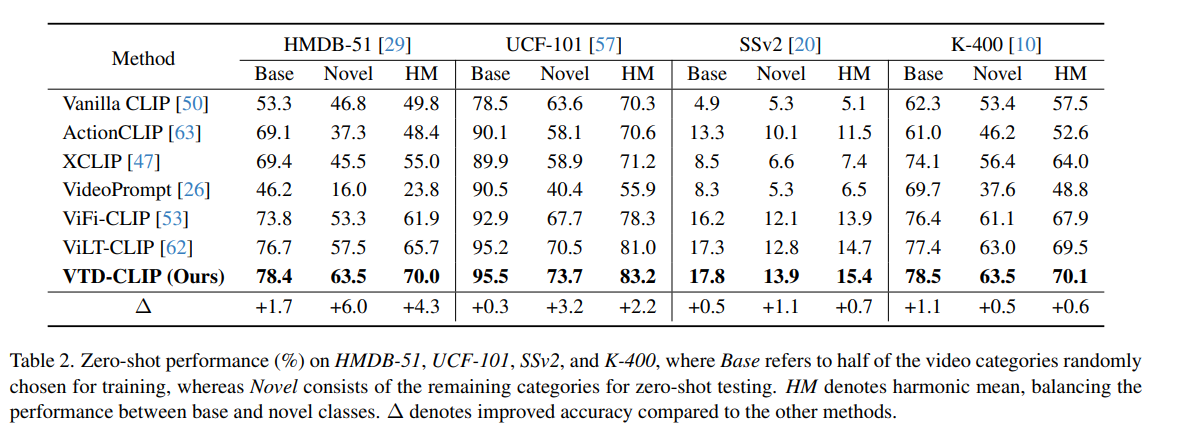
零样本视频识别。为评估我们方法的泛化能力,我们建立了不重叠的基础类别和新类别用于评估,确保Cbase∩Cnovel=∅\mathbb{C}_{\text{base}} \cap \mathbb{C}_{\text{novel}}=\emptysetCbase∩Cnovel=∅。对于每个数据集,我们将类别随机分为两组:50%作为基础类别,其余50%作为新类别。我们使用基础类别训练模型,并在新类别上验证其零样本能力。如表2所示,我们的方法在基础类别和新类别设置中均优于对比方法。值得注意的是,在识别新类别方面,我们比其他方法分别取得了6.0%、3.2%、1.1%和0.5%的显著性能提升。视觉特征与文本原型的强对齐可以减少对基础类别的过拟合。在SSv2和K-400数据集上的小幅提升表明,视频推理和复杂语义理解仍存在挑战。
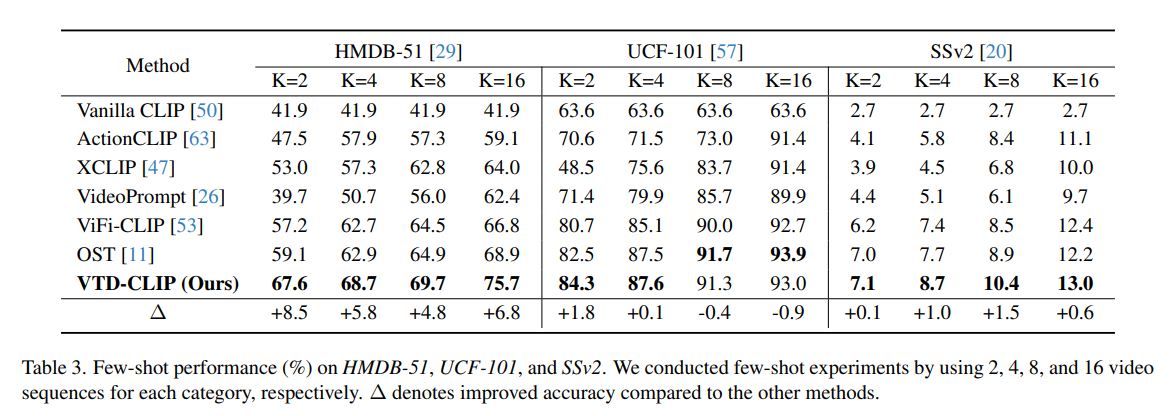
少样本视频识别。为评估我们的方法在有限数据条件下的有效性和泛化能力,我们在不同的样本设置下进行了实验。如表3所示,随着视频数量的增加,我们方法的准确率逐步提高。有了更多的视觉数据,文本特征的贡献减少,像以对象为中心的方法OST[11]等开始追赶。此外,我们的方法即使在样本有限的情况下也表现出显著的改进,这表明引入补充性的离散文本特征增强了模型的泛化能力,并减少了对视觉样本数量的依赖。
4.3 消融研究
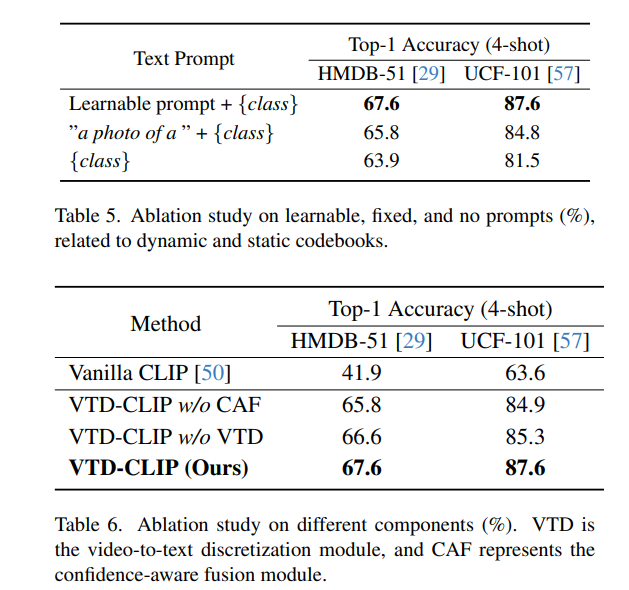
组件分析。为验证各个组件的贡献,我们在HMDB-51和UCF-101上进行了消融实验。如表6所示,视频到文本离散化和置信度融合共同增强了模型性能。VTD生成文本对齐特征,使CAF能够计算更可靠的置信度分数,而CAF确保VTD专注于语义丰富的片段,细化文本-帧对齐。它们的协同作用提高了我们方法的准确率,证实了这两个组件都是有效且必要的。
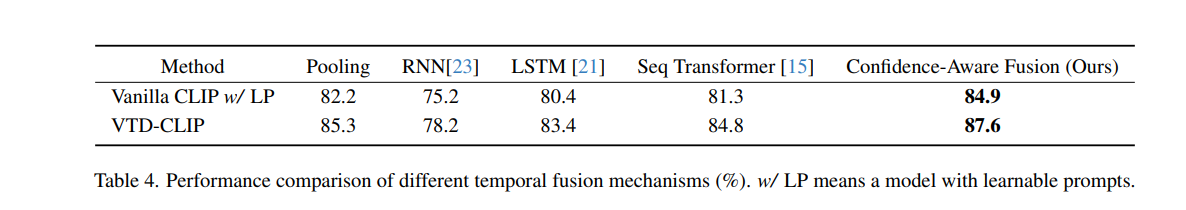
时序融合机制分析。我们进行消融实验以评估不同时序融合策略的影响,包括RNN[23]、LSTM[21]和具有4层网络结构的Seq Transformer[15]。表4展示了在UCF-101上4样本学习下的结果。我们的方法在Vanilla CLIP和VTD-CLIP框架中均优于所有策略,而平均池化取得了次优性能。RNN在视频任务中表现较差,因为其建模长程时序依赖的能力有限。置信度分数来自帧-文本相似度,并通过文本引导的语义抑制冗余帧。
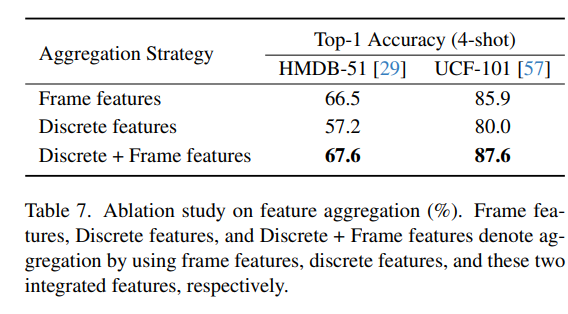
特征聚合分析。为探究不同特征的影响,我们对特征聚合进行了消融研究。我们导出融合特征ftf_{t}ft、帧特征xxx和离散特征vvv,以进行置信度感知融合以获得最终视频特征。表7显示,结合离散特征和帧特征的双流聚合策略显著取得了最佳性能。没有视觉信息的离散特征明显低于帧特征。仅视觉特征可能由于跨模态匹配不佳而与文本描述错位。我们假设离散特征保留高级动作语义,而帧特征提供空间细节。融合特征平衡了抽象信息和详细信息。
提示分析。为研究不同码本的影响,我们比较了三种码本变体:1) 具有可学习文本提示并通过反向传播微调的动态码本;2) 使用固定模板的静态码本;3) 具有原始类别标签的码本。表5显示,具有可学习提示的动态码本取得了更高的准确率,因为可学习提示允许动态细化文本嵌入以与视觉特征对齐。原始标签缺乏足够的上下文,而固定模板对于视频理解而言拟合不足。
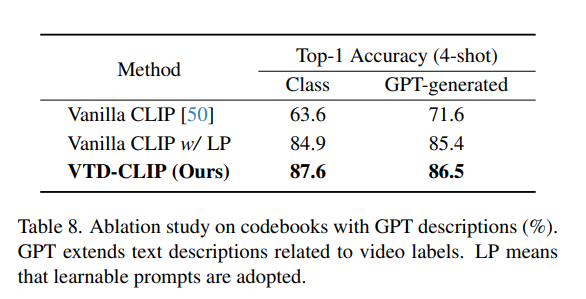
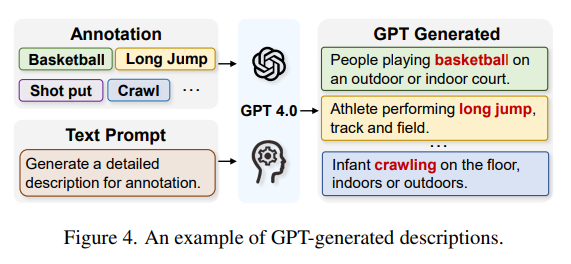
码本增强分析。我们通过使用GPT 4.0[2]生成图4中的详细类别描述,来探究码本增强的影响。表8显示了在UCF-101上的实验结果。GPT生成的描述可以通过添加更多细节来提高性能。然而,对于性能较强的模型,GPT冗长或有噪声的描述会破坏过度对齐的文本-帧特征。因此,只有当文本补充增强视觉语义时,才应利用外部知识(如GPT)。
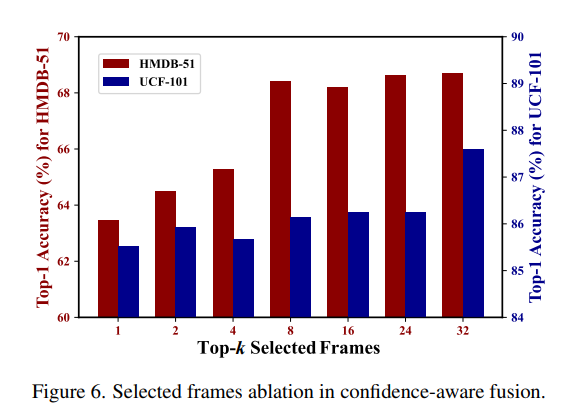
帧数量分析。为评估置信度感知融合中所选帧数量的影响,我们在4样本设置下进行了消融研究。我们在置信度感知融合中选择具有最高相似度的前k个帧。如图6所示,HMDB-51和UCF-101上的结果表明,帧数量较少时,可能会丢失重要信息,导致性能下降。当帧数量达到某个阈值后,随着额外帧带来的收益递减,模型性能趋于稳定。
4.4 可视化
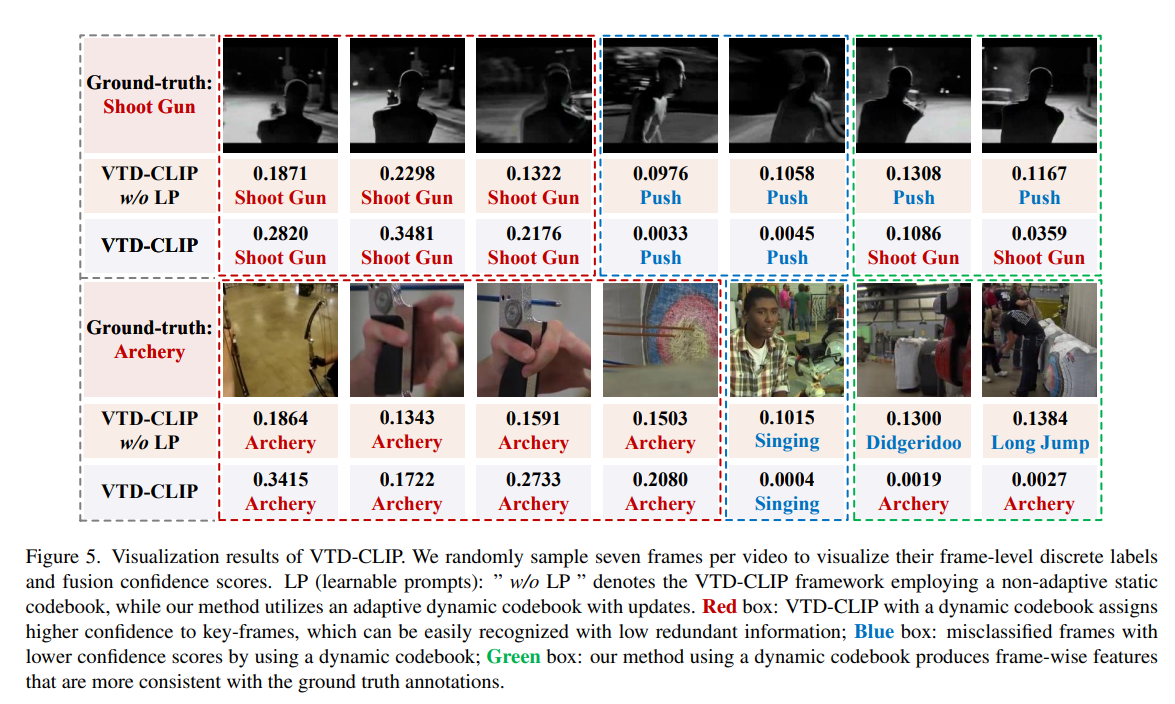
我们通过在图5中可视化码本,展示了VTD-CLIP的定性结果。与静态码本相比,动态机制增强了视频帧与文本描述之间的对齐,同时表现出更强的帧级判别能力。此外,我们的置信度感知加权策略有效地为关键帧分配更高的置信度(红框),同时自适应地降低错位片段(蓝框)和冗余但正确分类的帧(绿框)的权重。这种动态机制通过选择性权重提高了识别准确率,同时抑制了特征冗余。
5. 结论
在本文中,我们提出了一种简单而有效的用于视频理解的视频到文本离散化框架。我们将文本编码器重新构建为可训练的码本学习器,其中可学习提示支持自适应码本更新。然后,我们将帧特征离散化为文本原型,并通过置信度评分获得离散视频特征。最后,我们整合离散特征和帧特征进行特征融合和识别。实验结果表明,我们的方法与最先进的方法相比取得了有竞争力的结果。
局限性和未来工作:目前,我们仅探索了基于关键帧的视频总结来适配图像-文本模型,但时序建模对于交互或运动等任务至关重要。在未来的工作中,我们将设计一个利用视频镜头来处理动态视觉线索的框架。
思考:做法简单。将文本定义成码本,通过视频帧和文本的相似度计算,将视频帧映射到对应多少文本特征,称之为文本原型。
有意义的发现在于:在现实场景中,一小部分帧就足以代表整个视频的含义[28, 53],无需复杂的时序建模。